Intégrer l'IA générative dans son entreprise : les trois chantiers qui décident
Un pilote d'IA générative se monte en trois semaines. Une intégration qui tient six mois en production demande beaucoup plus, et l'écart vient rarement du modèle retenu. Sur les projets que nous livrons, les mêmes murs reviennent : personne ne sait répliquer les droits d'accès aux documents, personne ne mesure si la qualité des réponses se dégrade, personne n'a chiffré ce que coûtera la dix millième requête. Le modèle, lui, fonctionnait dès la première démonstration.
Le décalage se lit dans les chiffres de l'enquête TIC de l'INSEE publiée en juillet 2026 : en 2025, 18 % des entreprises françaises de 10 salariés ou plus déclarent utiliser au moins une technologie d'intelligence artificielle, contre 6 % en 2023. Le taux atteint 58 % au-delà de 250 salariés et retombe à 15 % entre 10 et 49 salariés. Déclarer un usage et avoir branché un modèle sur un processus qui tourne chaque jour restent deux situations très différentes.
Ce qui sépare un pilote convaincant d'une intégration qui tient
Un pilote traite les cas choisis par celui qui le présente, une intégration traite ce que les utilisateurs lui envoient. Toute la difficulté est dans cette phrase. En démonstration, les documents sont propres, les questions bien formulées, le périmètre tient sur une diapositive. En production, un commercial colle une capture d'écran floue, un juriste pose une question sur un contrat que le système n'a jamais indexé, un technicien interroge l'assistant à 7 h du matin pendant que la sauvegarde nocturne bloque la base.
La deuxième différence porte sur la durée. Un pilote vit six semaines, pendant lesquelles rien ne bouge autour. Une intégration doit survivre au changement de version du modèle côté fournisseur, au déménagement de la base documentaire, au départ de la personne qui avait écrit les prompts, à l'arrivée d'une équipe qui n'a pas assisté aux ateliers de cadrage. Les entreprises qui réussissent leur passage en production traitent ces quatre points comme des exigences de départ, pas comme de la maintenance.
La troisième différence est budgétaire. Le pilote coûte un forfait de prestation et quelques dizaines d'euros d'appels d'API. L'intégration coûte un poste récurrent, proportionnel à l'usage, qui grandit exactement quand le projet réussit. Beaucoup de comités de direction découvrent cette mécanique au premier trimestre complet de production, et la réaction est presque toujours la même : suspendre l'accès pendant qu'on réévalue. Une intégration bien préparée a chiffré cette courbe avant de la subir.
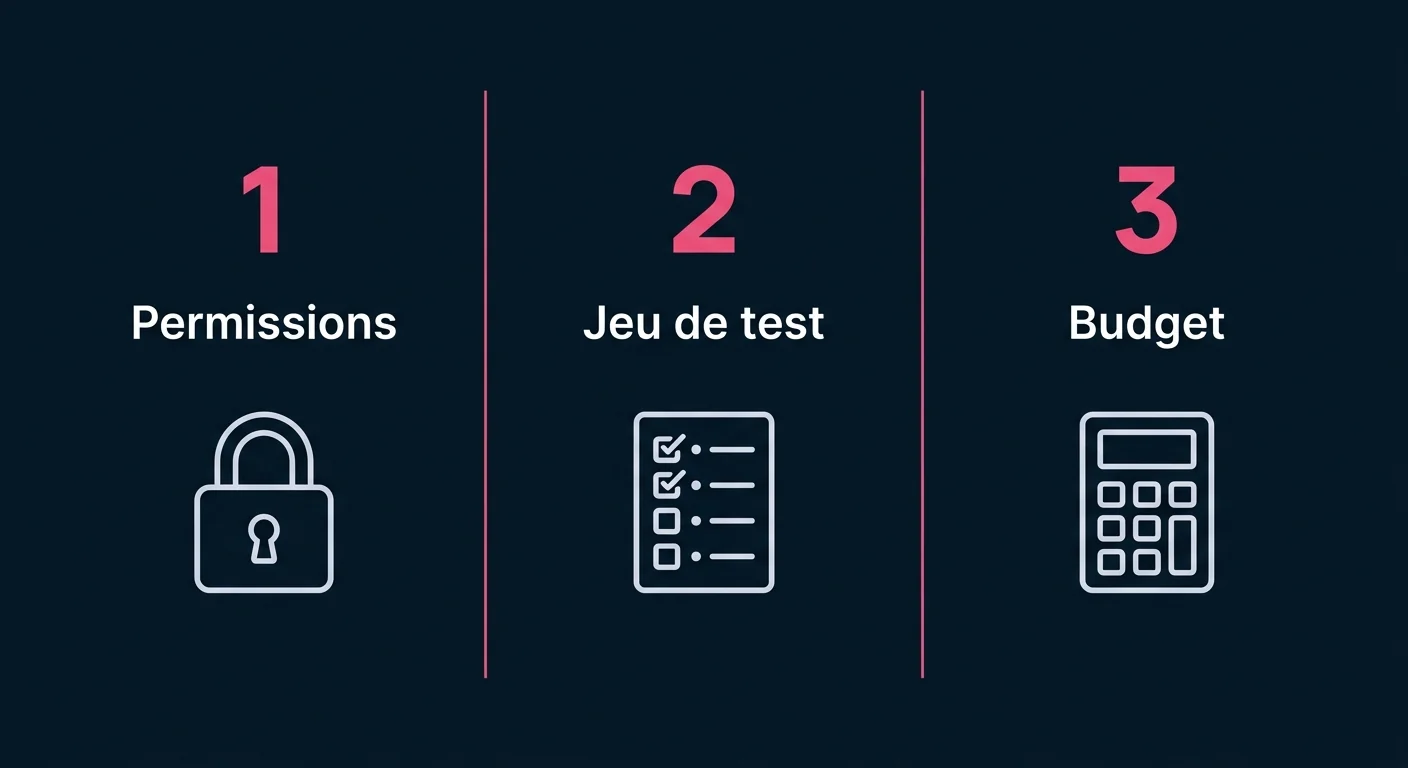
Ces trois différences se traduisent en trois chantiers concrets, dans cet ordre : les droits d'accès, la mesure de la qualité, le coût unitaire. Aucun des trois ne concerne le choix du modèle.
Les droits d'accès, le chantier que personne ne chiffre
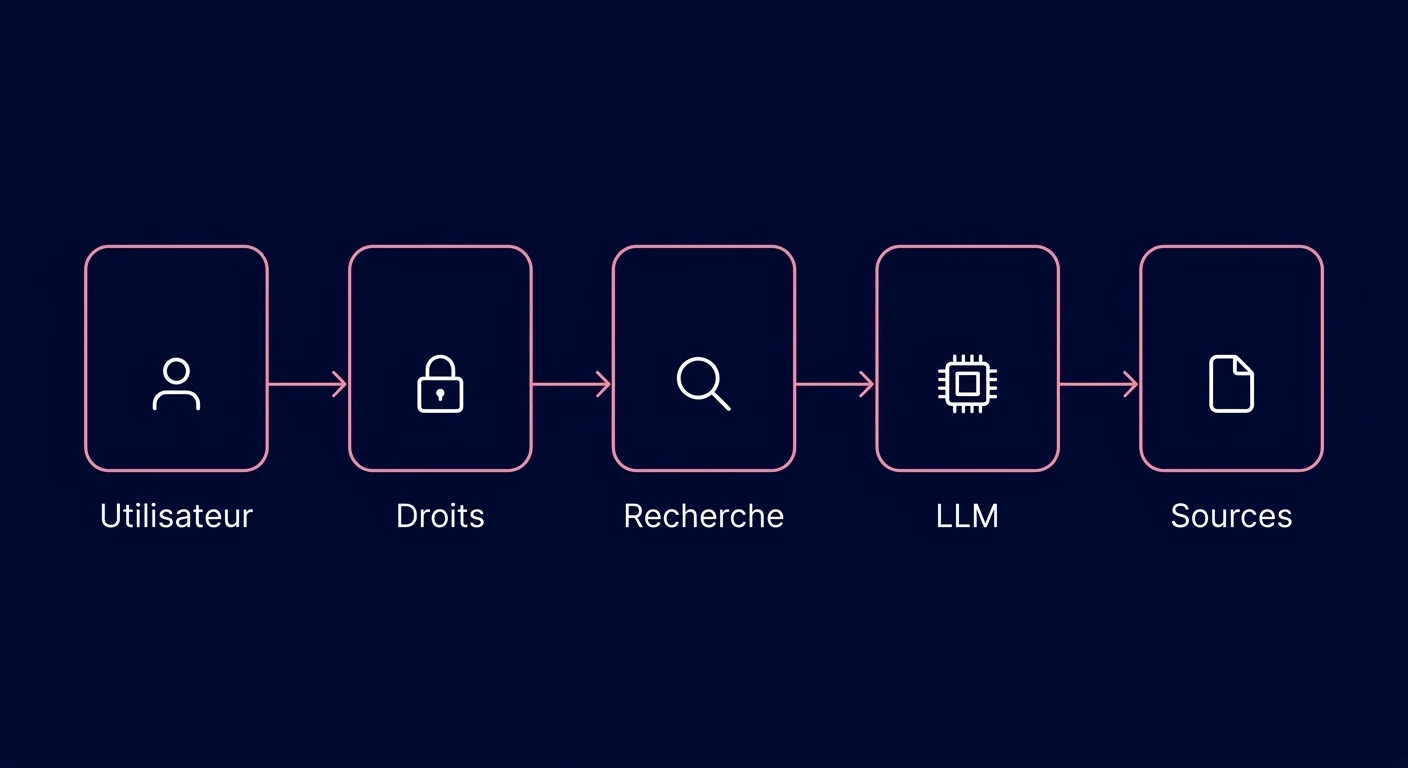
Un assistant qui lit la base documentaire de l'entreprise hérite d'un problème que l'entreprise n'a généralement jamais résolu : savoir précisément qui a le droit de lire quoi. Tant que les fichiers dorment sur un partage réseau, l'approximation passe inaperçue. Dès qu'un moteur de recherche sémantique les ingère et qu'un modèle en restitue le contenu en langage naturel, le premier salarié curieux obtient en trois secondes ce qu'il aurait mis deux heures à trouver à la main.
Le piège classique se joue à l'indexation. Une base vectorielle stocke des fragments de documents, et beaucoup d'implémentations les stockent sans leurs permissions d'origine. Le filtrage se fait alors après coup, dans le prompt, en demandant gentiment au modèle de ne pas citer certaines sources. Cette approche ne résiste à aucun test sérieux. La bonne mécanique consiste à porter les droits dans les métadonnées de chaque fragment, à filtrer au moment de la recherche avec l'identité réelle de l'utilisateur, puis à revérifier les fragments retenus avant de les envoyer au modèle. Si la mécanique de récupération documentaire vous est encore floue, notre article sur le fonctionnement d'un RAG en entreprise décrit la chaîne complète.
Deux effets de bord méritent d'être anticipés. D'abord, répliquer les permissions suppose que le système source expose une API de droits exploitable, ce qui est loin d'être acquis sur les GED anciennes et les partages de fichiers historiques. Ensuite, un changement de droits dans l'outil source doit se propager à l'index, sinon un document retiré à quelqu'un reste accessible via l'assistant pendant des jours. Sur les projets de taille moyenne que nous livrons, ce travail de synchronisation représente couramment un tiers de la charge d'intégration.
La CNIL a publié une série de fiches pratiques qui couvrent précisément ces points, notamment la sécurité des systèmes d'IA et l'annotation des données. Les consulter avant de concevoir l'architecture évite de refaire le travail après un audit : les fiches pratiques IA de la CNIL sont écrites pour des équipes projet, pas seulement pour des juristes.
Sans jeu de test, la qualité baisse sans que personne le voie
Une intégration qui n'a pas de jeu de test devient invérifiable dès la première modification. La raison est mécanique : un modèle de langage ne produit pas deux fois la même réponse, donc la seule façon d'affirmer qu'une modification améliore le système est de comparer deux séries de mesures. Sans cette base, chaque changement de prompt repose sur l'impression du dernier essai fait à la main par la personne qui a écrit le changement.
Le jeu de test utile est modeste. Cinquante à cent questions réelles, prélevées dans les tickets ou les échanges internes, avec pour chacune la réponse attendue et les sources qui doivent être citées. Cette collecte prend deux à trois jours de travail avec les métiers, et c'est le meilleur investissement du projet. Elle sert quatre fois : à valider la version initiale, à mesurer chaque changement de prompt, à décider si une nouvelle version du modèle est adoptable, à arbitrer entre deux fournisseurs sur des données maison plutôt que sur des classements publics.
La notation peut être automatisée en partie. Faire évaluer les réponses par un second modèle donne un score exploitable sur des critères simples, à condition d'avoir vérifié à la main que ce juge est d'accord avec un humain sur un échantillon. Notre article sur l'évaluation d'un modèle par un autre modèle détaille les biais connus de cette méthode, en particulier la préférence pour les réponses longues. Aux tarifs détaillés dans la section suivante, un jeu de cent questions passé sur un modèle intermédiaire coûte moins de deux dollars et tourne en quelques minutes, ce qui permet de l'exécuter à chaque modification plutôt qu'une fois par trimestre.
Le seuil d'acceptation se décide avec les métiers, pas avec la technique. Un assistant de recherche documentaire interne peut vivre avec 85 % de réponses correctes si les 15 % restants sont visiblement incertains. Un système qui rédige des courriers clients ne peut pas.
Le coût se calcule au token, pas à l'abonnement
Le prix d'une intégration se lit dans le volume de texte que chaque requête fait circuler. Un assistant qui répond à partir de documents internes injecte facilement 8 000 tokens en entrée, soit les extraits retrouvés plus les instructions système, et produit 500 tokens en sortie. Avec un modèle haut de gamme facturé 10 dollars le million de tokens en entrée et 50 dollars en sortie, la réponse revient à 0,105 dollar. Deux cents réponses par jour ouvré représentent environ 460 dollars par mois.
Le même calcul sur un modèle intermédiaire facturé 1,50 dollar en entrée et 7,50 dollars en sortie donne 0,0158 dollar par réponse, soit environ 70 dollars par mois pour le même volume. Le rapport est de 1 à 6,7 pour un travail que les deux modèles savent souvent faire aussi bien, puisqu'il s'agit de reformuler un contenu déjà retrouvé par le moteur de recherche. C'est exactement le genre d'arbitrage que le jeu de test de la section précédente permet de trancher sur des données réelles.
| Modèle | Entrée (par million de tokens) | Sortie (par million de tokens) |
|---|---|---|
| GPT-6 Astra | 10,00 $ | 50,00 $ |
| GPT-4o mini | 0,15 $ | 0,60 $ |
| Mistral Medium 3.5 | 1,50 $ | 7,50 $ |
| Mistral Small 4 | 0,15 $ | 0,60 $ |
Sources : tarifs API OpenAI et tarifs API Mistral, consultés le 20 septembre 2026.
Deux leviers réduisent la facture sans toucher à la qualité. Le cache d'entrée fait payer moins cher les portions de contexte déjà vues, avec une remise qui dépend du modèle : la grille citée plus haut affiche 1,00 dollar le million au lieu de 10,00 sur le modèle haut de gamme, et 0,075 dollar au lieu de 0,15 sur le modèle léger. Ce levier compte quand les instructions système et le socle documentaire sont stables d'une requête à l'autre. Le traitement par lots divise les tarifs par deux sur la même grille, à condition d'accepter un délai de réponse, donc il s'applique aux traitements nocturnes et pas à un assistant conversationnel. Pour construire un suivi budgétaire durable, notre guide sur le pilotage des coûts LLM en entreprise décrit les tableaux de bord et les garde-fous à poser dès la mise en production.
Où faire tourner le modèle quand les données sont sensibles
Trois endroits peuvent accueillir le modèle : l'API d'un fournisseur américain, un modèle ouvert hébergé chez un fournisseur européen, ou vos propres machines. Le choix se joue sur la nature des données plus que sur la performance brute. La première voie consiste à appeler l'API d'un fournisseur américain avec un engagement contractuel de non-entraînement sur les données transmises. C'est la voie la plus rapide, la moins chère en ingénierie, et elle convient à beaucoup de cas internes sans données personnelles sensibles. Elle devient discutable dès que les documents contiennent des données de santé, des dossiers RH nominatifs ou des secrets industriels.
La deuxième voie est le modèle ouvert hébergé chez un fournisseur européen. Le tableau de la section précédente situe les ordres de grandeur : un modèle intermédiaire européen se facture 1,50 dollar le million de tokens en entrée, loin des 10,00 dollars d'un modèle haut de gamme. L'hébergement se contractualise en droit européen, et les modèles ouverts récents couvrent la majorité des tâches d'extraction, de reformulation et de synthèse documentaire. La contrepartie est une offre plus restreinte sur le très haut de gamme et un écosystème d'outillage moins fourni. Notre comparatif des options pour héberger un LLM souverain détaille les configurations et les coûts d'infrastructure associés.
La troisième voie est l'exécution sur vos propres machines. Elle a un sens réel quand les données ne doivent physiquement pas sortir, ou quand le volume est tel que la facture à l'usage dépasse l'amortissement du matériel. Elle suppose en revanche une équipe capable de dimensionner des GPU, de gérer les files d'attente et de mettre à jour les modèles, compétences que peu de PME ont en interne. Quand ce chantier dépasse les moyens de l'équipe, le faire cadrer par une agence spécialisée dans les agents IA coûte moins cher qu'une première tentative ratée.
Ces trois options se mélangent très bien. Router les questions banales vers un petit modèle hébergé en Europe et les cas complexes vers une API haut de gamme est une architecture courante, qui demande simplement un point de passage unique dans le code pour changer de destination sans réécrire l'application.
Le calendrier réglementaire que l'intégration doit suivre
Le règlement européen sur l'IA s'applique par paliers depuis février 2025, et son régime général de transparence est en vigueur depuis le 2 août 2026. Entré en vigueur le 1er août 2024, il a rendu applicables ses interdictions de pratiques et ses obligations de formation du personnel en février 2025, puis les obligations des fournisseurs de modèles à usage général en août 2025. Les règles applicables aux systèmes à haut risque dans les domaines sensibles entrent en application le 2 décembre 2027. Le cadre réglementaire publié par la Commission européenne détaille ce calendrier échéance par échéance.
Les sanctions sont dimensionnées pour être dissuasives. Le texte officiel prévoit jusqu'à 35 millions d'euros ou 7 % du chiffre d'affaires annuel mondial pour le non-respect des pratiques interdites, et jusqu'à 15 millions d'euros ou 3 % pour les manquements aux obligations des fournisseurs et déployeurs, le montant le plus élevé étant retenu. Les PME et les jeunes entreprises bénéficient du plafond le plus faible entre les deux. Ces montants figurent à l'article 99 du règlement (UE) 2024/1689 publié au Journal officiel.
Pour une intégration interne classique, assistant documentaire ou aide à la rédaction, le régime applicable reste celui de la transparence et de la formation des utilisateurs, pas celui du haut risque. Cela ne dispense pas de tenir un inventaire des systèmes déployés, de documenter les données utilisées et d'informer les salariés qu'ils interagissent avec une machine. Ce sont ces trois pièces que les auditeurs demandent en premier, et ce sont celles qui manquent le plus souvent.
Le RGPD continue de s'appliquer par-dessus, avec ses propres exigences sur la base légale, la durée de conservation des historiques de conversation et les droits des personnes. Notre article sur la gouvernance IA en entreprise face au RGPD et à l'AI Act traite l'articulation des deux textes, qui n'a rien d'évident quand les deux inventaires vivent dans des services différents.
Un plan d'intégration en 90 jours qui ne finit pas en pilote abandonné
Le découpage qui fonctionne tient en trois phases d'un mois, avec une décision explicite à la fin de chacune. Le premier mois sert à choisir un processus unique et mesurable, puis à construire le jeu de test avec les métiers avant d'écrire la moindre ligne de code. Le critère de sortie est une série de questions réelles avec leurs réponses attendues, et un chiffre de référence sur le temps que le processus prend aujourd'hui.
Le deuxième mois construit la chaîne complète sur un périmètre documentaire restreint, permissions comprises. Restreint veut dire une équipe, un type de document, un cas d'usage. Le but n'est pas de couvrir le catalogue mais de faire passer une requête de bout en bout, avec l'identité réelle de l'utilisateur, le filtrage des droits, l'appel au modèle, la citation des sources et la trace de la requête dans les journaux. Le critère de sortie est le score obtenu sur le jeu de test et le coût moyen par requête mesuré, pas estimé.
Le troisième mois ouvre à une population plus large et installe l'exploitation : tableau de bord des coûts, alerte sur les dépassements, procédure de mise à jour du modèle avec repassage du jeu de test, recueil des retours utilisateurs. Le critère de sortie est la décision d'étendre ou d'arrêter, prise sur des chiffres et non sur une impression. Un projet qui s'arrête proprement à ce stade a coûté trois mois et laissé derrière lui un jeu de test et une cartographie des droits réutilisables.
Une remarque sur la conduite de ce plan. Le sponsor doit être le responsable du processus visé, jamais la direction informatique seule. Les intégrations qui échouent ont presque toujours en commun un pilotage purement technique, avec des métiers consultés en atelier de lancement puis plus jamais. Si vous en êtes au stade du cadrage et que le choix du processus à traiter n'est pas tranché, contacter Noxcod pour un premier échange coûte moins qu'un trimestre passé sur le mauvais cas d'usage.
Questions fréquentes sur l'intégration de l'IA générative
Combien de temps faut-il pour intégrer l'IA générative à un processus métier ?
Comptez trois mois pour un premier processus mené de bout en bout, jeu de test et gestion des droits compris. Les démonstrations se montent en trois semaines, mais elles sautent précisément les deux chantiers qui prennent du temps. Pour les processus suivants, la durée tombe souvent à quatre ou six semaines, puisque la chaîne technique, les permissions et l'outillage de mesure sont déjà en place et se réutilisent.
Faut-il un modèle haut de gamme pour un assistant documentaire interne ?
Rarement. Quand le moteur de recherche a déjà retrouvé les bons extraits, le travail restant consiste à reformuler et à citer, ce qu'un modèle intermédiaire fait correctement pour un coût six à sept fois inférieur. La bonne méthode consiste à passer les deux modèles sur le même jeu de test de questions réelles, puis à comparer les scores et les coûts avant de trancher.
Nos données partent-elles entraîner le modèle du fournisseur ?
Cela dépend du contrat souscrit, et ce point se vérifie noir sur blanc avant tout envoi de données. Exigez la clause écrite qui traite de l'usage des données pour l'entraînement : elle ne dit pas la même chose selon qu'il s'agit d'une offre professionnelle négociée ou d'un compte grand public qu'un salarié ouvre de sa propre initiative. Un modèle hébergé en Europe ou sur vos propres machines lève la question par construction, puisque les données ne quittent pas le périmètre contractuel que vous maîtrisez.
Que faire des assistants que les salariés utilisent déjà sans autorisation ?
Les inventorier avant de les interdire. Un usage informel signale un besoin réel et indique où l'intégration officielle aura le plus de valeur. La séquence utile consiste à recenser les outils employés, à proposer une alternative encadrée sur les deux ou trois cas les plus fréquents, puis à poser une règle écrite. Interdire sans alternative déplace simplement l'usage vers les téléphones personnels.
Comment savoir si une nouvelle version du modèle casse quelque chose ?
En repassant le jeu de test avant de basculer, et en gardant la possibilité de revenir à la version précédente pendant quelques semaines. Les fournisseurs publient régulièrement de nouvelles versions dont le comportement diffère sur des cas limites, en particulier sur le respect du format de sortie demandé. Sans mesure automatisée, la dégradation se découvre par les plaintes des utilisateurs, avec plusieurs semaines de retard.