Un projet RAG qui déçoit se diagnostique presque toujours au même endroit. On montre à un décideur une réponse fausse, il conclut que le modèle invente, et l'équipe part changer de LLM. Dans la plupart des dossiers qui arrivent chez nous, le modèle avait raison : il a répondu correctement à partir des passages qu'on lui avait servis, et ces passages ne contenaient pas l'information. Le défaut vit dans la moitié récupération du système, celle que personne ne mesure.
Le RAG, pour retrieval augmented generation, consiste à chercher des extraits pertinents dans vos documents, puis à les coller dans le prompt d'un modèle de langage avant qu'il rédige sa réponse. L'idée tient en deux phrases. Sa mise en production tient plutôt en deux mois, et le gros du travail porte sur des sujets peu spectaculaires : la lecture des PDF, la taille des extraits, les métadonnées, la façon de trier les résultats, et un jeu de questions de référence qui dit si la recherche progresse ou régresse.
Cet article décrit ce pipeline dans l'ordre où il casse, avec les réglages qui comptent et ceux qui font perdre du temps.
Ce que le RAG fait, et ce qu'il ne répare pas
Le RAG apporte des réponses ancrées sur vos documents à jour, citables et supprimables, sans réentraîner quoi que ce soit ; il ne corrige en revanche ni une documentation qui se contredit, ni une question qui demande un calcul. Le mécanisme tient en deux temps qui ne tournent pas au même rythme. L'ingestion s'exécute hors ligne : on lit les documents, on les découpe en extraits, on calcule pour chacun un vecteur qui encode son sens, et on range le tout dans une base vectorielle avec ses métadonnées. La requête s'exécute en ligne, en quelques centaines de millisecondes : la question de l'utilisateur est vectorisée à son tour, la base rend les extraits les plus proches, un composant les reclasse, et le modèle rédige à partir de ces extraits uniquement.
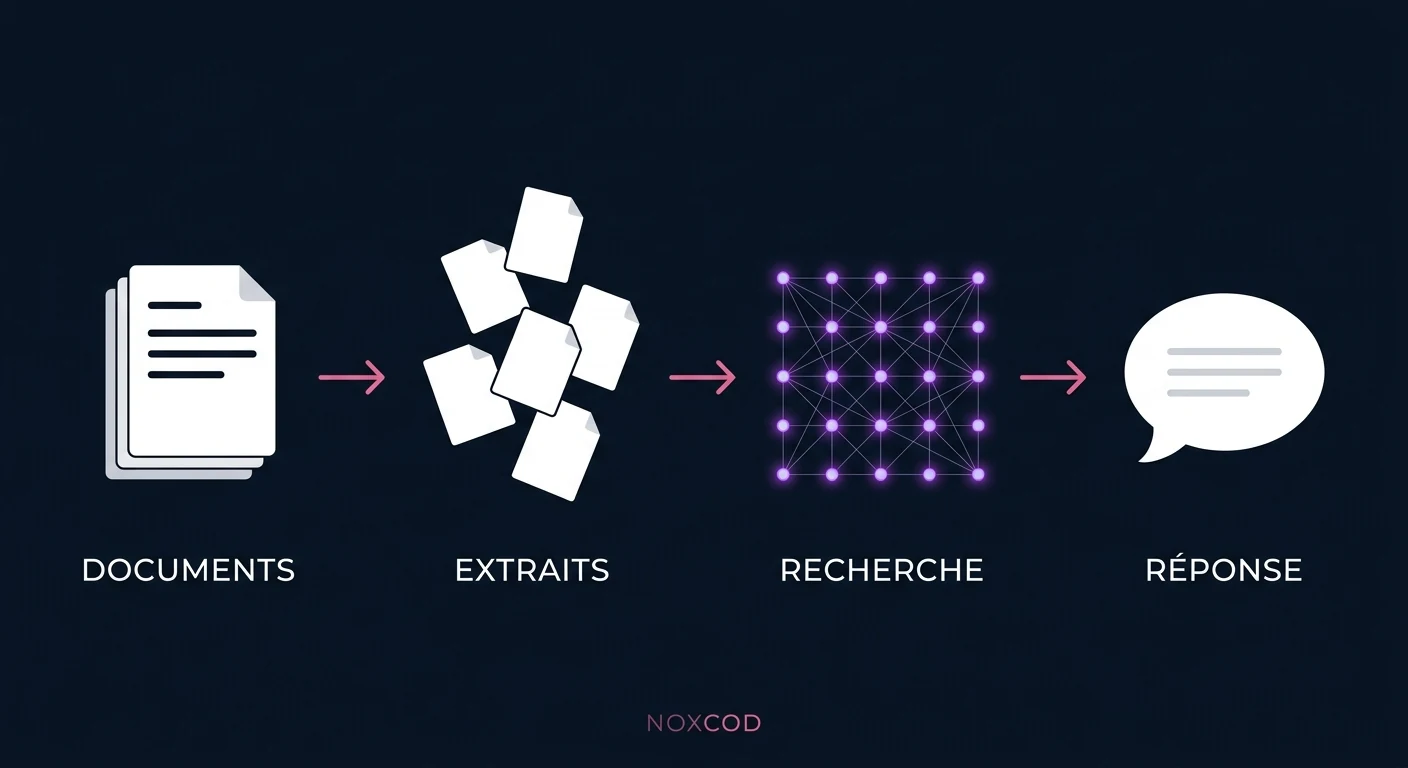
L'intérêt opérationnel se voit dès la première mise à jour documentaire. Ajouter un document revient à l'indexer, pas à relancer un entraînement de plusieurs heures. C'est la raison pour laquelle le RAG l'emporte sur un fine-tuning du modèle dans la plupart des cas d'usage documentaires d'entreprise : le fine-tuning enseigne un style, un format et un vocabulaire métier, il n'injecte pas des faits qui changent toutes les semaines.
Ses limites méritent d'être dites aussi franchement. Le RAG ne corrige pas une documentation contradictoire : si deux notes internes se contredisent, le système en servira une, parfois l'autre, sans arbitrer. Il ne remplace pas une base de données quand la question porte sur un calcul ou un décompte, du type « combien de commandes sont en retard ce mois-ci » : une recherche sémantique rapproche des textes, elle ne compte pas des lignes. Et il ne compense pas une mauvaise compréhension du fonctionnement d'un modèle par l'équipe qui le déploie ; savoir comment fonctionne un LLM et ce qu'il fait réellement d'un contexte long change la façon dont on conçoit le pipeline.
Un dernier point, souvent découvert trop tard : le RAG ne sert à rien si les réponses n'existent nulle part dans le corpus. Avant de choisir une base vectorielle, ouvrez dix questions réelles et cherchez leur réponse à la main dans vos documents. Si vous ne la trouvez pas vous-même, aucun système ne la trouvera.
Le découpage des documents décide de la qualité des réponses
Un extrait mal coupé produit une réponse fausse même avec un modèle parfait, et c'est le défaut le plus fréquent des pipelines que nous auditons. Un extrait trop court perd son contexte : « le délai est de quinze jours » ne sert à rien si le titre de section qui dit de quoi on parle est resté dans l'extrait précédent. Un extrait trop long dilue le signal, parce que son vecteur moyenne des sujets différents, la recherche devient floue et le modèle reçoit trois paragraphes de bruit pour une phrase utile.
Les modèles d'embeddings posent une borne haute. La documentation OpenAI donne 8192 tokens d'entrée au maximum pour text-embedding-3-small et text-embedding-3-large, avec des vecteurs de 1536 et 3072 dimensions par défaut. Cette borne est un plafond technique, jamais une cible : découper en extraits de 8000 tokens produit des vecteurs inexploitables en recherche.
Sur les corpus documentaires français que nous traitons, le découpage qui tient est structurel plutôt que mécanique. On suit les titres, les sections, les articles d'un contrat, les lignes d'un tableau, et on recopie dans chaque extrait le fil d'Ariane de sa section, pour qu'il reste lisible isolément. Un découpage par nombre de caractères fixe se code en dix minutes et se paie ensuite en réponses tronquées pendant des mois.
Avant le découpage, il y a la lecture des fichiers, et beaucoup de projets y laissent leurs premières semaines. Un PDF exporté depuis un traitement de texte se lit bien. Un PDF scanné, un tableau sur deux colonnes, un document avec en-tête et pied de page répétés à chaque page, un export d'outil métier : chacun demande un traitement particulier. Un tableau aplati en texte donne des lignes où la valeur ne se rattache plus à sa colonne, et le système répondra de travers avec beaucoup d'assurance. Les métadonnées ferment cette étape. Chaque extrait doit porter sa source, sa date, sa version et son périmètre d'accès, puisque ce sont elles qui permettront ensuite de filtrer, de citer et de cloisonner.
La recherche vectorielle seule rate les termes exacts
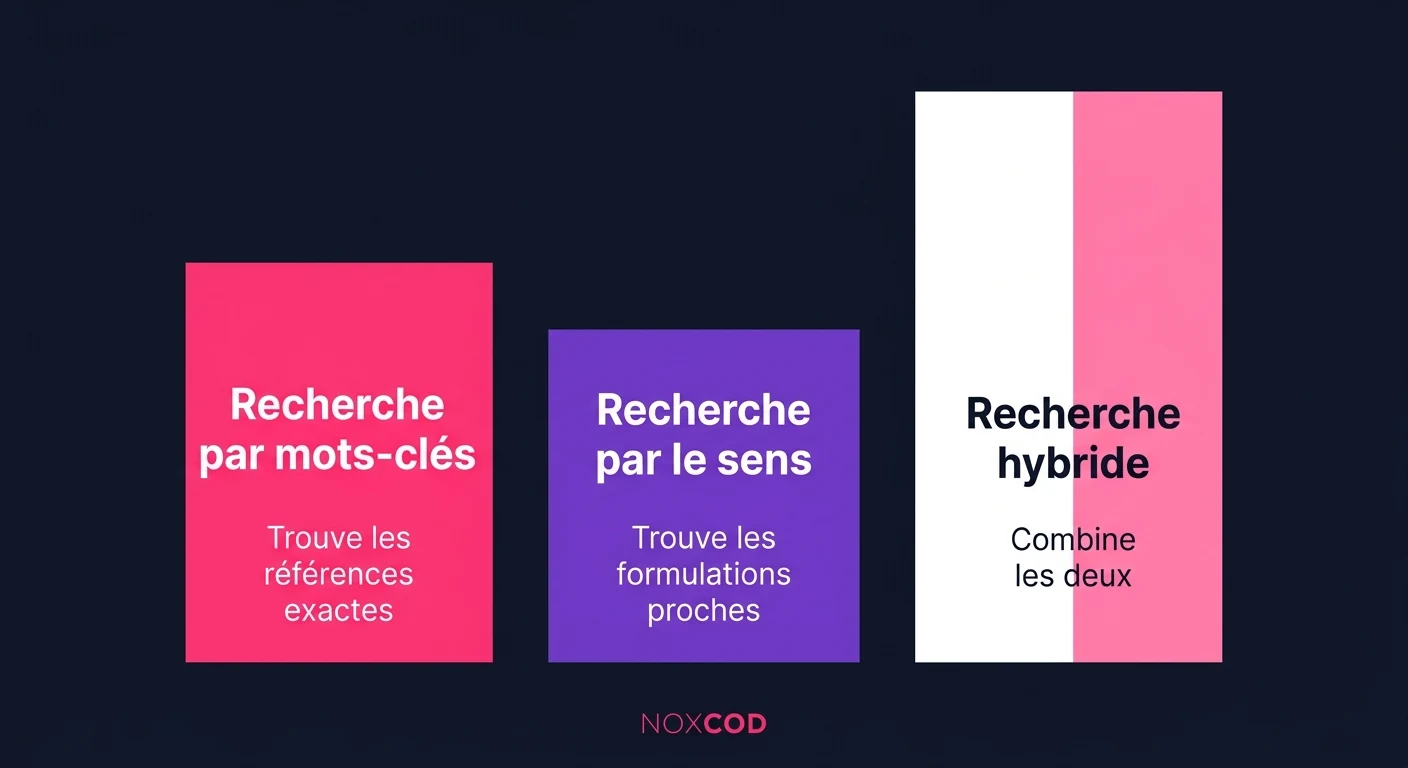
Un embedding ne mémorise pas la chaîne « TX-4471 », il en encode une impression approximative, et votre référence produit devient introuvable. La recherche vectorielle excelle sur le sens : elle rapproche « congé pour enfant malade » de « absence pour garde d'enfant » sans aucun mot commun. Elle reste mauvaise sur les chaînes exactes, les numéros de contrat, les codes article et les noms propres rares, qui sont précisément ce que les utilisateurs tapent dans une barre de recherche interne.
La correction connue s'appelle recherche hybride : croiser la recherche vectorielle avec une recherche lexicale classique de type BM25, puis fusionner les deux classements. La documentation de Qdrant décrit deux méthodes de fusion. Le Reciprocal Rank Fusion applique la formule score(d) = Σ 1/(k + rang), avec k à 2 par défaut, configurable depuis la version 1.16.0 et pondérable par source depuis la 1.17.0. La fusion par distribution, disponible depuis la 1.11.0, normalise les scores sur une plage de trois écarts-types avant de les combiner.
La même page de Qdrant pose deux limites qu'aucune page marketing ne mentionne, et qui se vérifient en projet. D'abord, régler les poids à la main sans jeu d'évaluation ne bat pas les valeurs par défaut de façon fiable. Ensuite, quand la collection est répartie sur plusieurs shards, la fusion se calcule shard par shard : le classement fusionné est local, pas global, ce qui change le résultat dès que le corpus grossit.
Reste le reranking, et c'est le levier au meilleur rapport travail sur gain. Un modèle de reranking relit les vingt ou trente extraits remontés et les reclasse en comparant vraiment la question à chaque extrait, au lieu de comparer deux vecteurs calculés séparément à des moments différents. Le surcoût se compte en dizaines de millisecondes. Si vous ne devez ajouter qu'une pièce à un RAG existant qui déçoit, commencez par celle-là avant de toucher au reste.
Sans jeu d'évaluation, vous corrigez à l'aveugle
Trente questions réelles, avec pour chacune l'extrait qui contient la réponse, suffisent à savoir si une modification améliore ou dégrade le système. Ce jeu se construit en une journée, à partir des questions que les utilisateurs posent déjà par mail ou au support. Le travail est métier plutôt que technique, et il vaut mieux qu'un responsable du domaine le fasse, parce qu'un développeur écrit spontanément les questions auxquelles son pipeline sait répondre.
Avec ce jeu, on mesure d'abord la récupération, avant toute considération sur le modèle de génération. La question posée à chaque itération tient en une ligne : parmi les k extraits remontés, le bon extrait est-il présent ? Si la réponse est non dans trois cas sur dix, changer de LLM ne servira à rien. Cette mesure sépare proprement les deux moitiés du système, et elle est la seule qui progresse de façon lisible quand on change le découpage, le modèle d'embeddings ou la méthode de fusion.
L'ordre compte ensuite, pas seulement la présence. Les travaux de Liu et de ses coauteurs sur les longs contextes, publiés en 2023 sous le titre Lost in the Middle, montrent que les modèles exploitent le mieux l'information placée au début ou à la fin du contexte, et que la performance se dégrade nettement quand l'information pertinente se trouve au milieu. Servir quinze extraits dont le bon en septième position revient donc à le cacher. Trois à cinq extraits bien classés valent mieux que vingt jetés en vrac dans le prompt.
Un LLM juge peut ensuite noter la qualité des réponses finales à grande échelle, une fois la récupération sous contrôle. L'erreur classique consiste à commencer par là : un juge automatique qui note des réponses construites sur de mauvais extraits produit une note basse et aucune information exploitable. Les équipes qui suivent cet ordre passent des semaines à réécrire des prompts pour un problème qui vivait dans l'index.
Le coût d'un RAG se joue à la réindexation
Changer de modèle d'embeddings ou de stratégie de découpage oblige à recalculer la totalité de l'index, et c'est cette répétition qui fait la facture, jamais l'indexation initiale. Le prix unitaire, lui, reste dérisoire. Trois références relevées le 16 septembre 2026 sur les pages officielles des fournisseurs :
| Modèle d'embeddings | Prix affiché | Contexte maximum |
|---|---|---|
| text-embedding-3-small (OpenAI) | 0,02 $ par million de tokens | 8192 tokens |
| text-embedding-3-large (OpenAI) | 0,13 $ par million de tokens | 8192 tokens |
| bge-multilingual-gemma2 (OVHcloud AI Endpoints) | 0,01 € par million de tokens | 8192 tokens |
Sources : tarifs OpenAI et catalogue OVHcloud AI Endpoints, consultés le 16/09/2026.
Un corpus de dix mille pages représente grossièrement quinze à vingt millions de tokens, soit moins d'un euro à indexer au tarif le plus bas. La facture d'indexation initiale n'est donc jamais le sujet. La raison pour laquelle un changement de modèle impose de tout recalculer tient à la nature des vecteurs : ceux d'un modèle ne sont pas comparables à ceux d'un autre, et il n'existe aucune migration partielle. Modifier la stratégie de découpage impose le même passage complet. Sur un corpus vivant, l'ingestion incrémentale tourne en continu et chaque nouvelle version d'un document réindexe ses extraits.
Les postes qui pèsent réellement sur douze mois se trouvent ailleurs : l'hébergement de la base vectorielle et sa mémoire, car un index de plusieurs millions de vecteurs en 3072 dimensions ne tient pas dans une petite instance ; l'inférence du modèle de génération à chaque requête ; le reranking ; et le temps humain de maintenance du pipeline quand un format de source change sans prévenir. Une agence qui chiffre un RAG sans ces quatre lignes chiffre une démonstration, et nos équipes d'experts en agents IA passent une partie de leur temps à rattraper ce genre de devis.
Une économie facile existe côté dimensions. La page d'OpenAI sur les embeddings indique, sur le benchmark MTEB, qu'un vecteur text-embedding-3-large raccourci à 256 dimensions via le paramètre dimensions reste meilleur qu'un vecteur ada-002 complet à 1536 dimensions. Diviser la dimension par douze divise d'autant la mémoire de l'index et accélère la recherche. Le réglage se teste sur le jeu d'évaluation en une demi-journée, et il se justifie dès que le corpus dépasse le million d'extraits.
RGPD : le cloisonnement se conçoit avant l'ingestion
Le filtre qui décide qui a le droit de lire quel extrait s'applique dans la requête envoyée à la base vectorielle, et il se prépare au moment où l'on écrit les métadonnées, donc avant d'ingérer le premier document. Un RAG d'entreprise avale des documents internes, et des documents internes contiennent des données personnelles : dossiers RH, contrats, comptes rendus d'entretien, échanges clients. La base vectorielle devient alors un nouveau lieu de stockage de ces données, avec ses copies, ses sauvegardes et son index.
Deux exigences structurent l'architecture. Le cloisonnement d'abord, puisque chaque extrait doit porter dans ses métadonnées le périmètre autorisé à le lire, et que le filtre s'applique dans la requête à la base plutôt qu'après coup dans le code applicatif. Un filtrage posé trop tard laisse passer des fuites entre services ou entre clients, et ce type de défaut ne se voit pas en recette, parce qu'il faut précisément la mauvaise question du mauvais utilisateur pour le déclencher. L'effacement ensuite : quand une personne exerce son droit, il faut pouvoir supprimer ses extraits et leurs vecteurs, ce qui suppose de savoir quel document a produit quel extrait et de conserver ce lien pendant toute la vie de l'index.
Le cadre s'est précisé. La CNIL a publié le 7 février 2025 des recommandations sur l'IA et le RGPD qui portent notamment sur l'information des personnes et sur l'exercice de leurs droits dans les systèmes d'IA. Le règlement européen sur l'IA, entré en vigueur le 1er août 2024, est applicable depuis le 2 août 2026 pour la majeure partie de ses obligations, après une première vague au 2 février 2025 sur les pratiques interdites et la littératie en IA.
Pour beaucoup d'organisations françaises, la conséquence pratique est un choix d'hébergement. Un RAG souverain hébergé en France coûte plus cher en infrastructure qu'un appel à une API américaine, et il évite un transfert hors Union européenne dont la justification devient un chantier juridique à part entière. Le calcul se pose projet par projet, en fonction de la sensibilité réelle du corpus, pas en principe.
Mettre un premier RAG en production sans y passer six mois
Un périmètre documentaire fermé, un cas d'usage unique et un jeu de questions écrit avant la première ligne d'indexation : la séquence tient en trois décisions prises au départ. Commencez par la base de connaissances du support, les procédures qualité ou les contrats fournisseurs. Un RAG « sur tous les documents de l'entreprise » finit par n'être bon nulle part, parce que le découpage optimal d'un contrat ne ressemble en rien à celui d'un fil de tickets.
Écrire le jeu d'évaluation avant de coder l'indexation paraît contre-intuitif et sauve pourtant le projet. Les questions réelles dictent le découpage, les métadonnées nécessaires et les filtres. Elles révèlent aussi, dès le premier jour, les questions auxquelles votre corpus ne peut pas répondre, ce qui redirige le chantier vers la production de contenu manquant plutôt que vers un réglage technique sans issue.
Montez ensuite une maquette locale pour valider le corpus avant d'investir dans l'infrastructure. Une maquette RAG locale avec AnythingLLM suffit à savoir si les documents portent vraiment les réponses attendues, et cette question se tranche en deux jours au lieu de deux mois. L'industrialisation vient après : ingestion incrémentale, journalisation des requêtes et des extraits servis, filtres d'accès, supervision des coûts. La journalisation mérite une insistance particulière, parce qu'elle est la seule façon d'améliorer le système une fois en production. Sans la trace des extraits réellement envoyés au modèle, une plainte utilisateur reste indiagnosticable.
Sur le choix de faire seul ou accompagné, notre position est tranchée. Un RAG de démonstration se monte en une semaine par un développeur curieux, et la démonstration impressionne toujours. Un RAG qui tient en production sur des données sensibles demande des compétences en traitement documentaire, en recherche d'information et en conformité, et c'est le point exact où les équipes internes calent le plus souvent. Nous intervenons régulièrement à ce moment, pour reprendre un prototype qui brillait en réunion et qui s'effondre sur les vraies questions. Si vous en êtes là, contacter Noxcod fait gagner plusieurs semaines sur l'audit du pipeline.
Questions fréquentes sur le RAG
Faut-il choisir entre RAG et fine-tuning ?
Les deux répondent à des besoins différents et se combinent très bien. Le RAG apporte des faits à jour, traçables et supprimables, ce qui couvre la majorité des usages documentaires. Le fine-tuning apporte un style, un format de sortie et un vocabulaire métier que le prompt seul n'obtient pas de façon stable. Commencez toujours par le RAG : il est moins cher, réversible, et il vous dira si le problème restant est un problème de forme.
Une base vectorielle dédiée est-elle nécessaire ?
Pas au démarrage. Sur les projets que nous livrons, une extension vectorielle greffée sur la base PostgreSQL déjà en place tient sans difficulté un corpus de quelques centaines de milliers d'extraits, et elle évite d'ajouter un service à exploiter. L'ordre de grandeur est le nôtre, il dépend de votre matériel et de vos réglages. Une base vectorielle dédiée devient justifiée au-delà de quelques millions de vecteurs, ou quand vous avez besoin de fonctions avancées comme la recherche hybride native, le filtrage fin par métadonnées ou la répartition sur plusieurs shards.
Combien de temps pour un RAG en production ?
Comptez deux à trois semaines pour une maquette utile sur un corpus propre et fermé, et six à dix semaines pour une mise en production avec filtres d'accès, ingestion incrémentale, journalisation et évaluation continue. Le facteur qui fait le plus varier ce délai reste la qualité des sources : un corpus de PDF scannés ou de documents mal structurés ajoute facilement un mois de traitement documentaire.
Le RAG supprime-t-il les réponses inventées ?
Il les réduit fortement sans les éliminer. Un modèle bien contraint répond « je ne trouve pas » quand les extraits ne portent pas la réponse, à condition que le prompt le lui demande explicitement et que la citation des sources soit imposée. Le risque résiduel se déplace : le système invente moins, mais il peut servir avec assurance un extrait périmé. La date dans les métadonnées et l'affichage de la source côté utilisateur restent les meilleures protections.
Comment savoir si mon RAG s'améliore ?
En suivant deux courbes sur le même jeu de questions, à chaque modification. La première mesure la récupération : le bon extrait figure-t-il parmi les k premiers résultats ? La seconde mesure la réponse finale, notée par un humain ou par un modèle juge. Sans ces deux courbes, chaque changement de découpage ou de modèle devient une décision d'opinion, et les régressions passent inaperçues jusqu'à la plainte utilisateur.