Un système multi-agents IA confie une tâche à plusieurs agents, chacun doté de ses consignes, de ses outils et de sa propre fenêtre de contexte, coordonnés par un orchestrateur ou par des passages de relais. Il bat un agent unique quand la tâche se découpe en sous-tâches indépendantes qui débordent le contexte d'un seul modèle. Dans les autres cas, il coûte plus cher et casse plus souvent.
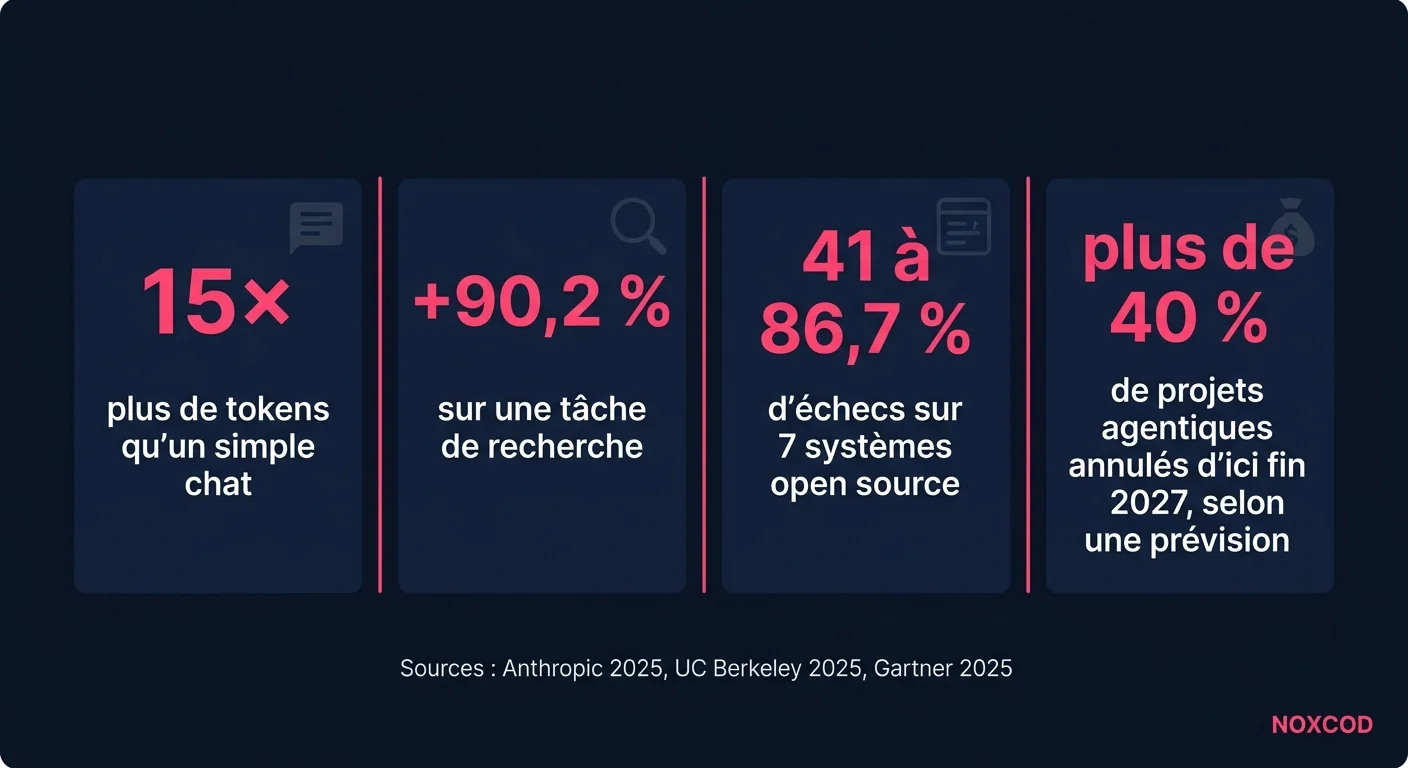
Les ordres de grandeur sont publics. Anthropic mesure qu'un système multi-agents consomme environ 15 fois plus de tokens qu'une conversation classique. Une équipe de UC Berkeley relève entre 41 % et 86,7 % d'échecs sur sept systèmes multi-agents open source. Sur des agents vocaux que nous exploitons, nous avons vu des agents rester bloqués pendant tout un appel, faute d'un passage de relais bien écrit.
Système multi-agents IA : ce qui le distingue d'un agent unique
Un système multi-agents se distingue d'un agent unique par le découpage du contexte : chaque agent ne voit que ce qu'on lui transmet, avec son propre prompt système et sa propre liste d'outils. Un agent seul accumule tout dans une même fenêtre, ses recherches, ses essais ratés et ses résultats intermédiaires. Plusieurs agents répartissent cette charge, au prix d'une coordination à concevoir.
Pour mémoire, un agent est un modèle de langage qui tourne en boucle : il lit la demande, choisit un outil, observe le résultat et recommence jusqu'à juger la tâche finie. Si ce mécanisme reste flou, commencez par ce qu'est vraiment un agent IA, puis par la boucle de raisonnement d'un agent LLM. Le multi-agents empile plusieurs de ces boucles.
La documentation de Claude Code décrit bien cette isolation. Chaque sous-agent tourne dans sa propre fenêtre de contexte, avec un prompt système dédié, un accès aux outils restreint et des permissions indépendantes. Il ne voit ni l'historique de la conversation principale ni les fichiers déjà lus. Il rend un résumé, et c'est ce résumé seul qui remonte.
Une chaîne de trois appels à un LLM dans un ordre figé reste un workflow, même si chaque appel porte un rôle différent. On parle de système multi-agents quand un agent décide lui-même de déléguer ou de passer la main. La nuance compte, parce qu'un workflow se teste comme du code classique, alors qu'un système qui décide de ses délégations se teste comme un modèle, par répétition.
L'intérêt des entreprises est réel. Gartner rapporte une hausse de 1 445 % des demandes de ses clients sur le sujet entre le premier trimestre 2024 et le deuxième trimestre 2025, et prévoit que 70 % des systèmes multi-agents utiliseront des agents très spécialisés d'ici 2027. Ce chiffre mesure des questions posées à des analystes, pas des systèmes en production. Nous le lisons comme un signal de curiosité, rien de plus.
Orchestrateur, relais ou relecteur : les trois architectures qui tiennent
Trois architectures couvrent la quasi-totalité des systèmes multi-agents que nous croisons en projet : l'orchestrateur qui délègue en parallèle, le relais entre agents spécialisés, et le couple producteur et relecteur. Elles se combinent, mais chacune répond à un problème différent.
L'orchestrateur est l'architecture qu'Anthropic a retenue pour son outil de recherche. Un agent principal analyse la question, planifie, puis lance des sous-agents qui explorent chacun une piste en parallèle. Chaque sous-agent condense ce qu'il a trouvé avant de le rendre, et l'orchestrateur assemble. Le gain vient de la parallélisation et de la compression : l'agent principal ne lit jamais les dizaines de pages parcourues, seulement les synthèses.
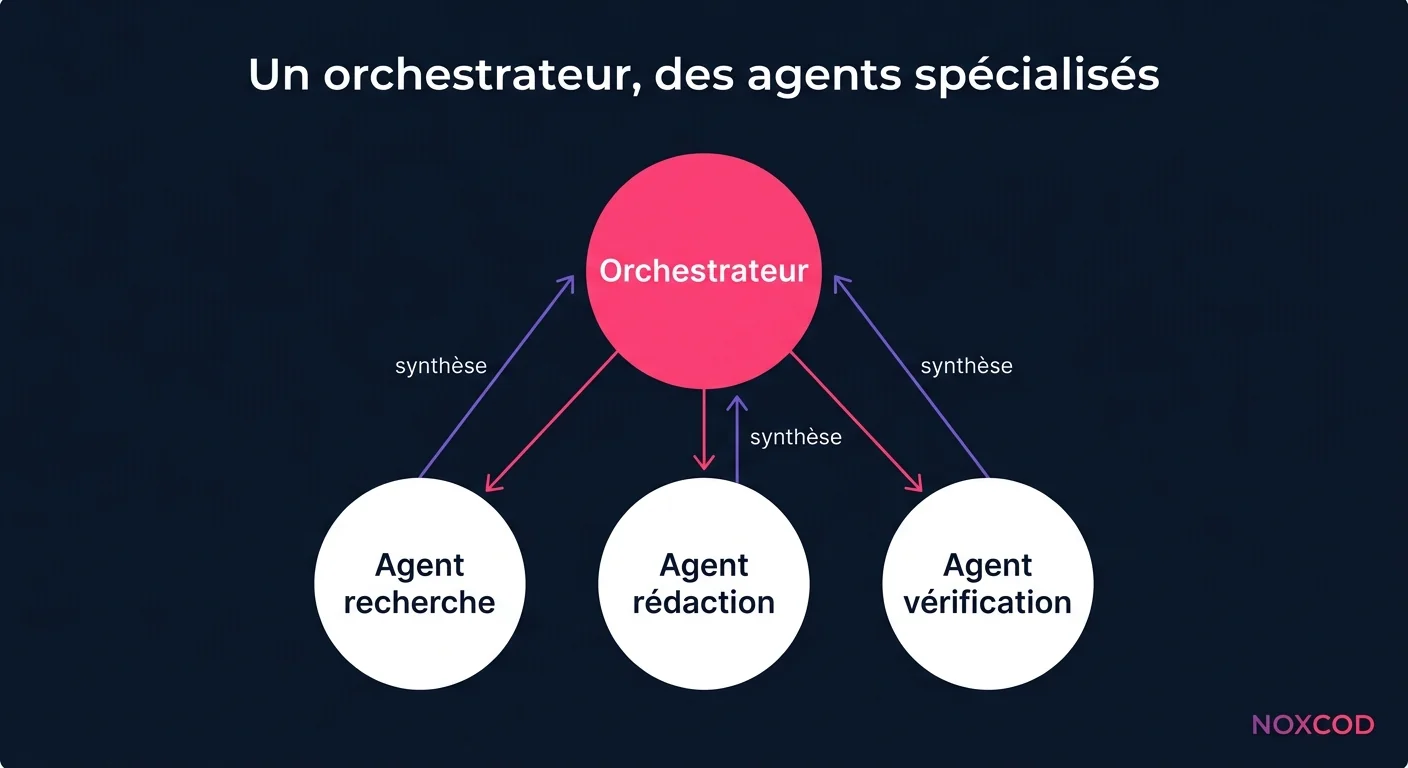
Le relais fonctionne autrement. Un seul agent est actif à la fois, et il passe la main à un collègue spécialisé quand la conversation change de nature. Dans le SDK d'agents d'OpenAI, ces passages sont présentés au modèle comme des outils : un relais vers un agent nommé Refund Agent devient un outil appelé transfer_to_refund_agent. Le cas typique est un support client où un agent de tri oriente vers l'agent des commandes, celui des remboursements ou celui de la FAQ. Retenez ce détail, il explique la panne que nous racontons plus bas.
Le couple producteur et relecteur sépare la fabrication du contrôle. Un agent produit un livrable, un second le vérifie contre une grille de critères, avec un contexte neuf. Sur nos projets, le relecteur reçoit le livrable et la liste des règles, jamais le raisonnement du producteur : il juge ce qui sort, sans se laisser convaincre par ce qui a été voulu. La technique rejoint celle qui consiste à faire évaluer une sortie par un second modèle.
Deux protocoles encadrent ces échanges. Le protocole MCP relie un agent à des outils et à des sources de données. Le protocole A2A relie des agents entre eux, y compris chez des éditeurs différents : créé par Google, il est devenu un projet de la Linux Foundation le 23 juin 2025, avec le soutien annoncé de plus de 100 entreprises.
Cas d'usage : quand plusieurs agents font mieux qu'un seul
Plusieurs agents font mieux qu'un seul quand la tâche se découpe en pistes indépendantes explorables en parallèle, et quand chaque piste produirait assez de résultats intermédiaires pour saturer le contexte d'un agent unique. La recherche documentaire coche les deux cases, et c'est là que les mesures publiques sont les plus nettes.
Sur son évaluation interne de recherche, Anthropic indique qu'un système avec Claude Opus 4 en orchestrateur et des sous-agents Claude Sonnet 4 a dépassé de 90,2 % le même Claude Opus 4 travaillant seul. L'exemple cité consiste à retrouver les membres des conseils d'administration de toutes les entreprises du secteur technologique du S&P 500, une liste qui se partage naturellement. Sur l'évaluation BrowseComp, la quantité de tokens consommés explique à elle seule 80 % des écarts de performance. Un système multi-agents sert donc surtout à dépenser davantage de tokens sur un problème, en parallèle, sans noyer un contexte unique.
Les cas d'usage qui suivent cette logique se ressemblent :
- la veille et la recherche multi-sources, avec un agent par piste ou par famille de sources ;
- l'audit d'un volume de documents ou d'une base de code découpée en lots, suivi d'une synthèse ;
- la relecture multi-critères d'un livrable, un relecteur par grille (sécurité, conformité, cohérence) ;
- le support client à tri, où chaque agent spécialisé garde un prompt court et des outils limités ;
- l'extraction de données sur de gros lots de contrats ou de factures, avec un agent de vérification.
À l'inverse, Anthropic écrit que les domaines où tous les agents doivent partager le même contexte, ou qui comportent beaucoup de dépendances entre agents, conviennent mal aux systèmes multi-agents actuels. La plupart des tâches de code contiennent moins de sous-tâches vraiment parallélisables que la recherche. Notre avis va dans le même sens pour la rédaction d'un document cohérent et pour la conversation en temps réel : un agent unique, avec de bons outils, y reste le meilleur choix.
Ce que coûte un système multi-agents : tokens, latence et erreurs
Un système multi-agents coûte en tokens, en latence et en erreurs : environ 15 fois les tokens d'une conversation classique, au moins un appel de modèle de plus à chaque délégation, et des erreurs qui passent d'un agent au suivant. Les données publiées par Anthropic montrent qu'un agent seul consomme déjà environ 4 fois plus de tokens qu'un chat. L'éditeur en tire lui-même la conséquence : l'architecture ne se justifie que sur des tâches dont la valeur couvre ce surcoût.
Avant d'écrire la première ligne, chiffrez donc une exécution type. Multipliez le coût d'un appel de votre agent actuel par le nombre de sous-agents prévus, puis par le nombre de tours de chacun. Si le résultat dépasse ce que vaut la tâche pour le métier, le découpage n'est pas le bon levier. Plafonnez aussi le nombre de sous-agents qu'un orchestrateur peut lancer, faute de quoi il en lancera trop sur une question simple.
La latence suit le même chemin : un orchestrateur attend le sous-agent le plus lent avant de rédiger sa réponse. Pour un rapport rendu en dix minutes, cela ne gêne personne. Au téléphone, l'appelant entend le silence. Sur les agents vocaux que nous développons, une seule étape parle à la fois et la main passe de l'une à l'autre, sans orchestration parallèle.
Les erreurs, enfin, s'additionnent. L'étude de UC Berkeley a annoté 1 642 traces d'exécution issues de sept frameworks multi-agents, et en tire 14 modes d'échec regroupés en trois familles : la conception du système, le désalignement entre agents et la vérification de la tâche. Un agent qui se trompe transmet son erreur au suivant, qui la traite comme un fait.
Les projets en paient le prix. Selon Gartner, plus de 40 % des projets d'IA agentique seront annulés d'ici fin 2027, à cause de coûts qui dérapent, d'une valeur métier floue ou de contrôles des risques insuffisants. Le cabinet estime aussi qu'environ 130 fournisseurs seulement, sur des milliers qui se revendiquent de l'IA agentique, proposent de vrais agents. Un système multi-agents mal justifié cumule ces trois risques.
Le passage de relais, là où les systèmes multi-agents cassent
Un passage de relais casse pour deux raisons : l'agent qui reçoit la main ne dispose que de ce que l'autre lui a transmis, et l'agent qui la donne décide seul du moment. Les deux défauts se corrigent, à condition de les traiter comme du prompt à part entière.
Chez Cognition, Walden Yan a formulé en juin 2025 deux principes de conception. Le premier demande de partager le contexte, et même les traces complètes des agents, plutôt que de simples messages. Le second rappelle que chaque action porte des décisions implicites, et que des décisions contradictoires donnent de mauvais résultats. Son exemple est parlant : pour cloner Flappy Bird, un sous-agent dessine un décor façon Mario pendant qu'un autre fabrique un oiseau qui ne se déplace pas comme dans le jeu, et l'agent final doit réconcilier deux pièces incompatibles.
Nous avons vécu la version conversationnelle de ce problème. Sur une plateforme d'agents vocaux que nous développons, un agent est découpé en étapes spécialisées, et il passe d'une étape à la suivante en appelant un outil de transition, exactement le mécanisme des relais du SDK d'OpenAI. Le texte de la condition de passage part au modèle comme description de cet outil, et nulle part ailleurs. Des agents restaient bloqués sur leur étape pendant tout un appel.
Pour isoler la cause, nous avons rejoué 40 fois un même tour de conversation réel, avec un tour témoin où le relais ne devait pas partir. Avec une condition écrite en style télégraphique, le modèle rapide que nous utilisions par défaut n'a déclenché le relais que 0 fois sur 40, et l'a déclenché à tort 13 fois sur 40 sur le tour témoin. Réécrite en phrase complète qui décrit la situation, la même condition est passée à 15 déclenchements justes et 2 à tort, toujours sur 40. Ajouter en plus la liste des sorties dans le prompt système a porté les déclenchements justes à 40 sur 40 dans deux formulations sur trois, mais les déclenchements à tort à 22 et 26 sur 40. Deux autres modèles testés n'ont produit aucun déclenchement prématuré : le défaut dépendait aussi du modèle.
La leçon tient en une règle. Une description de relais s'écrit comme une situation observable, avec ce qui doit s'être passé avant, et se teste sur des cas où le relais doit partir comme sur des cas où il ne doit pas partir. Une condition du type « rdv » ne dit rien au modèle. Une condition comme « l'appelant a donné son nom et demande un créneau précis » lui donne de quoi trancher, à titre d'exemple. Le banc complet a demandé 1 920 générations, rejouables à chaque changement de modèle.
Monter un premier système multi-agents, étape par étape
Un bon premier système multi-agents part d'un agent unique qui échoue de façon mesurée, et ne découpe qu'à l'endroit de cet échec. Partir d'un organigramme de cinq agents imaginé au tableau blanc produit l'inverse : des relais que personne n'a testés et une facture de tokens que personne n'a chiffrée.
- Construisez l'agent unique avec ses outils et un jeu de cas réels tirés de votre métier, puis notez précisément où il échoue, cas par cas, avant de toucher à l'architecture.
- Découpez sur un critère observable : un contexte saturé par des résultats intermédiaires, des pistes parallélisables, ou des droits d'accès aux outils qui doivent rester séparés.
- Écrivez le contrat de chaque agent : ce qu'il reçoit, le format exact de ce qu'il rend, et les outils qu'il a le droit d'utiliser.
- Rédigez chaque description de relais en phrase complète, puis testez-la contre des cas où le relais ne doit pas partir.
- Journalisez les traces complètes et rejouez chaque cas plusieurs dizaines de fois, car un même agent ne répond pas deux fois à l'identique.
Pour prototyper vite, Claude Code offre un terrain d'essai sans framework. Un sous-agent y est un fichier Markdown avec un en-tête YAML, rangé dans le dossier .claude/agents du projet. Le champ tools sert de liste blanche d'outils, le champ model choisit le modèle, et selon la documentation, un sous-agent peut lui-même en lancer d'autres jusqu'à trois niveaux sous la conversation principale. Versionné avec le code, ce dossier documente l'architecture mieux qu'un schéma.
En production, le choix du framework dépend de votre stack. Le SDK d'agents d'OpenAI couvre bien les relais, LangGraph donne un contrôle fin sur le graphe d'états, et nous expliquons ailleurs quand LangChain se justifie pour des agents IA. Aucun ne dispense des étapes 4 et 5. Si vous préférez confier la conception à une équipe qui a déjà fait casser ces relais, notre agence spécialisée en agents IA part de vos cas réels avant de proposer une architecture.
Questions fréquentes sur les systèmes multi-agents IA
Combien d'agents prévoir dans un premier système multi-agents ?
Deux, le plus souvent. Un agent qui produit et un agent qui vérifie, ou un orchestrateur et un seul type de sous-agent lancé plusieurs fois en parallèle. Chaque agent supplémentaire ajoute un contrat à écrire, des relais à tester et des tokens à payer. Ajoutez le troisième quand une mesure montre qu'un des deux sature, jamais parce que l'organigramme paraît plus complet avec cinq rôles.
Un workflow n8n ou Make qui appelle plusieurs fois un LLM est-il un système multi-agents ?
Pas au sens strict. Si l'ordre des appels est fixé dans le workflow, il s'agit d'une chaîne d'appels, plus simple à tester et souvent suffisante. Le système devient multi-agents quand un agent choisit lui-même de déléguer ou de passer la main selon la situation. Beaucoup de besoins présentés comme agentiques se traitent très bien avec une chaîne fixe, moins chère et plus prévisible.
Faut-il utiliser le même modèle pour tous les agents ?
Non, et c'est souvent un levier d'économie. Le système de recherche d'Anthropic associe un modèle puissant en orchestrateur à des modèles plus rapides pour les sous-agents. Réservez le modèle le plus capable aux décisions de découpage et à la synthèse, et confiez l'exploration ou l'extraction à des modèles moins chers. Vérifiez chaque combinaison sur vos cas : un modèle peut respecter une condition de relais qu'un autre ignore.
MCP ou A2A : lequel mettre en place en premier ?
MCP d'abord, dans la grande majorité des projets. Il relie vos agents à vos outils et à vos données, ce dont tout agent a besoin dès le premier jour. A2A sert quand des agents doivent dialoguer entre systèmes ou entre éditeurs différents, par exemple votre agent et celui d'un fournisseur. Tant que tous vos agents vivent dans la même application, un appel de fonction interne suffit.