Jev ne rédige rien. Le premier modèle de TypeSafe reçoit une demande et une liste fermée d'actions possibles, choisit l'une d'elles et donne la probabilité qu'il attache à ce choix. L'annonce de TypeSafe promet des décisions bien plus rapides et moins chères qu'avec un LLM classique, et la sortie a fait parler. J'utilise déjà des petits modèles rapides pour ce genre de tri dans nos projets, alors j'ai voulu savoir si Jev faisait vraiment mieux.
Je l'ai passée sur un jeu de test public de 5 500 demandes, dont 1 000 n'ont aucune bonne réponse, puis je l'ai comparée à GPT-6 Luna, Claude Haiku, DeepSeek, GLM et Mistral sur les mêmes 500 demandes. Dans mon test, Jev a été rapide, n'est jamais sortie du format et a coûté peu. Sur le comparatif, GPT-6 Luna fait pourtant aussi juste, lance moins de mauvaises actions et revient moins cher grâce à son cache. Je trouve donc Jev un peu surcotée par rapport au buzz, et je la garde à l'œil. Tout le test est filmé dans la vidéo.
Ce que fait Jev et comment je l'ai testée
Jev choisit une action dans une liste que vous lui imposez, et j'ai mesuré ce choix sur CLINC150, un jeu de test public construit pour piéger les assistants avec des demandes hors de leur périmètre. Dans son annonce, TypeSafe décrit son modèle comme un appel de fonction : du texte libre en entrée, une décision typée en sortie, accompagnée d'une probabilité. Les sorties possibles sont définies à l'avance, et l'éditeur affirme que le modèle ne commet jamais d'erreur de type. ChatGPT ou Claude écrivent leur réponse mot après mot. Jev renvoie un choix.
Prenons un message arrivé au support : « mon application plante depuis la mise à jour ». Un modèle classique peut vous écrire trois paragraphes. Jev répond « demande technique » ou « demande de facturation », la seule information dont votre logiciel a besoin pour router le message. Sur des milliers d'e-mails à trier, cette réponse courte économise du temps de calcul et de l'argent, à condition que le choix soit juste.
Pour le vérifier, j'ai pris CLINC150, publié en 2019 par Stefan Larson et ses coauteurs, et mis en ligne par Clinc, une société spécialisée dans les assistants conversationnels. Le jeu couvre 150 intentions réparties dans 10 domaines, dont la banque, le voyage, la cuisine, la voiture et le travail. Ce sont des phrases courtes en anglais, écrites dans le style de vrais utilisateurs, comme dans une fenêtre de chat. Sa partie test, disponible sur la page Hugging Face du jeu CLINC150, compte 5 500 demandes : 4 500 ont une bonne action, 1 000 n'en ont aucune. Le jeu étiquette ces dernières « hors périmètre », et dans mon test, la bonne réponse consiste alors à passer la main à un humain. Les auteurs l'avaient déjà noté dans leur article de recherche : les classifieurs qu'ils ont évalués s'en sortaient bien sur les demandes prévues et peinaient à repérer celles qui ne l'étaient pas.
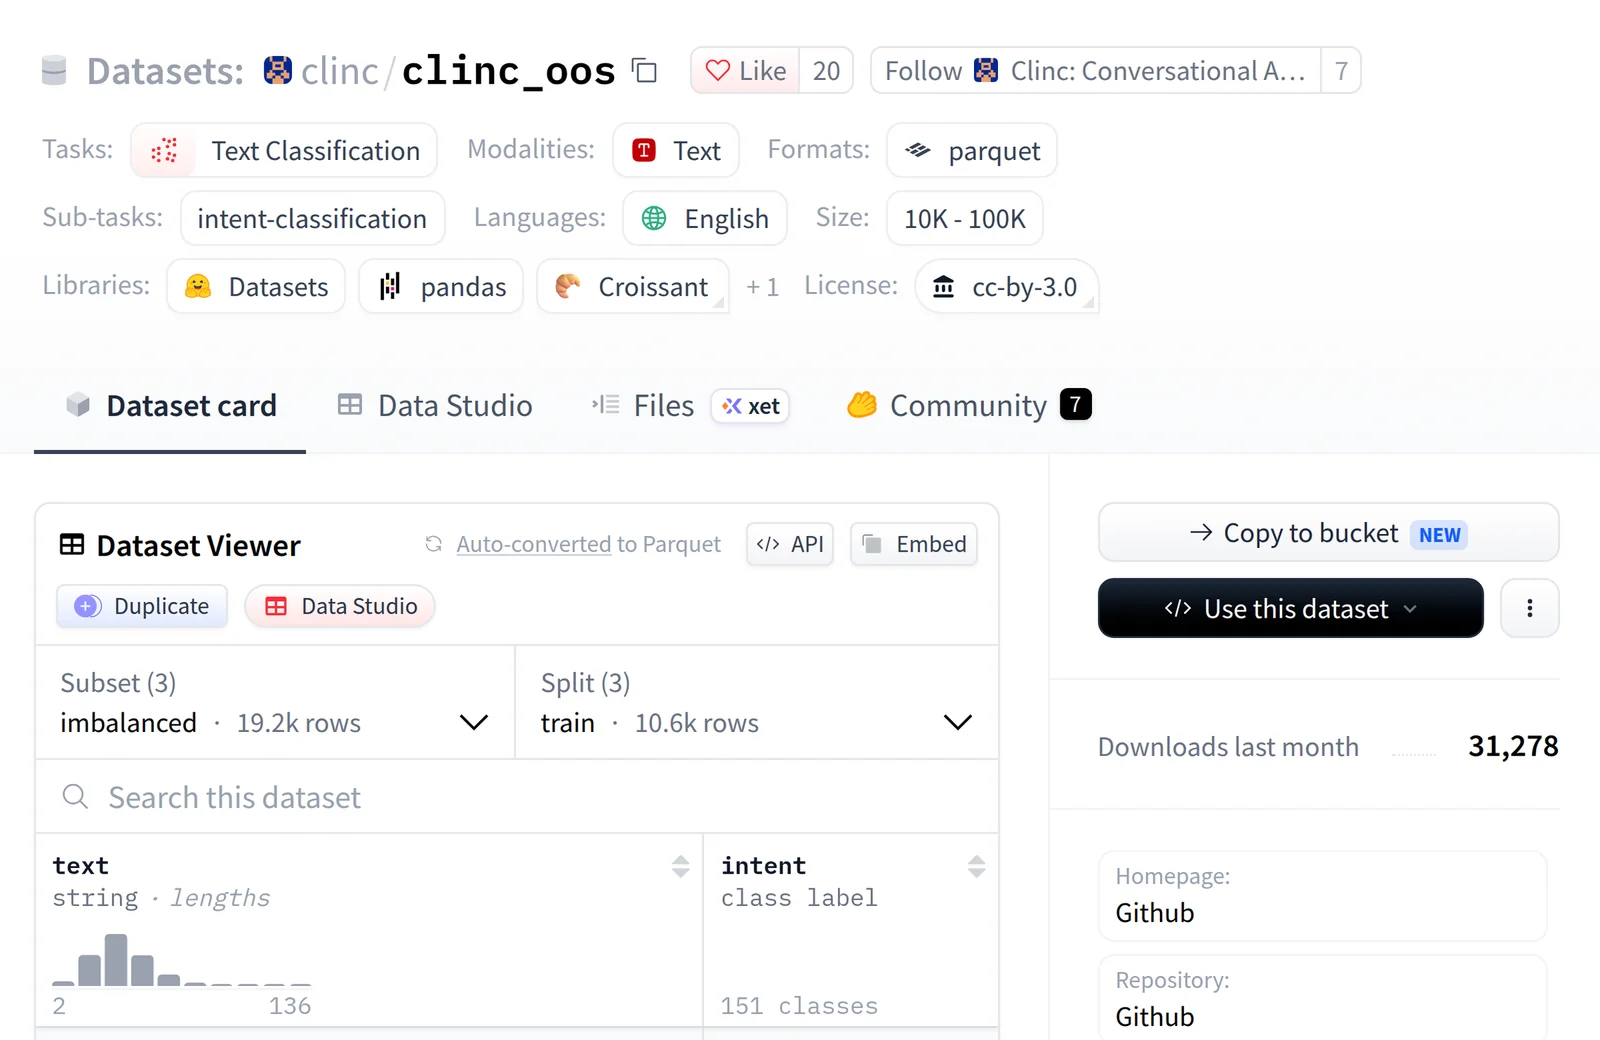
J'ai fait passer Jev dans deux situations. Dans le premier test, elle est obligée de choisir une des 150 actions, même quand aucune ne convient : sur les 1 000 demandes pièges, elle se trompe donc forcément. Dans le second, je lui ajoute une option, « passer la main à un humain », et je regarde si elle pense à s'en servir au bon moment. Je l'ai appelée via OpenRouter, sous le nom Jev 1.13. Cette passerelle qui donne accès à plusieurs modèles avec une seule clé d'API m'a permis d'appeler presque tous les modèles du comparatif par le même chemin ; seul Mistral Small 4 a été appelé en direct. Aucune action n'était réellement exécutée : je compare seulement le choix de chaque modèle à la bonne réponse du jeu de test.
La démo : obligée de choisir, puis autorisée à passer la main
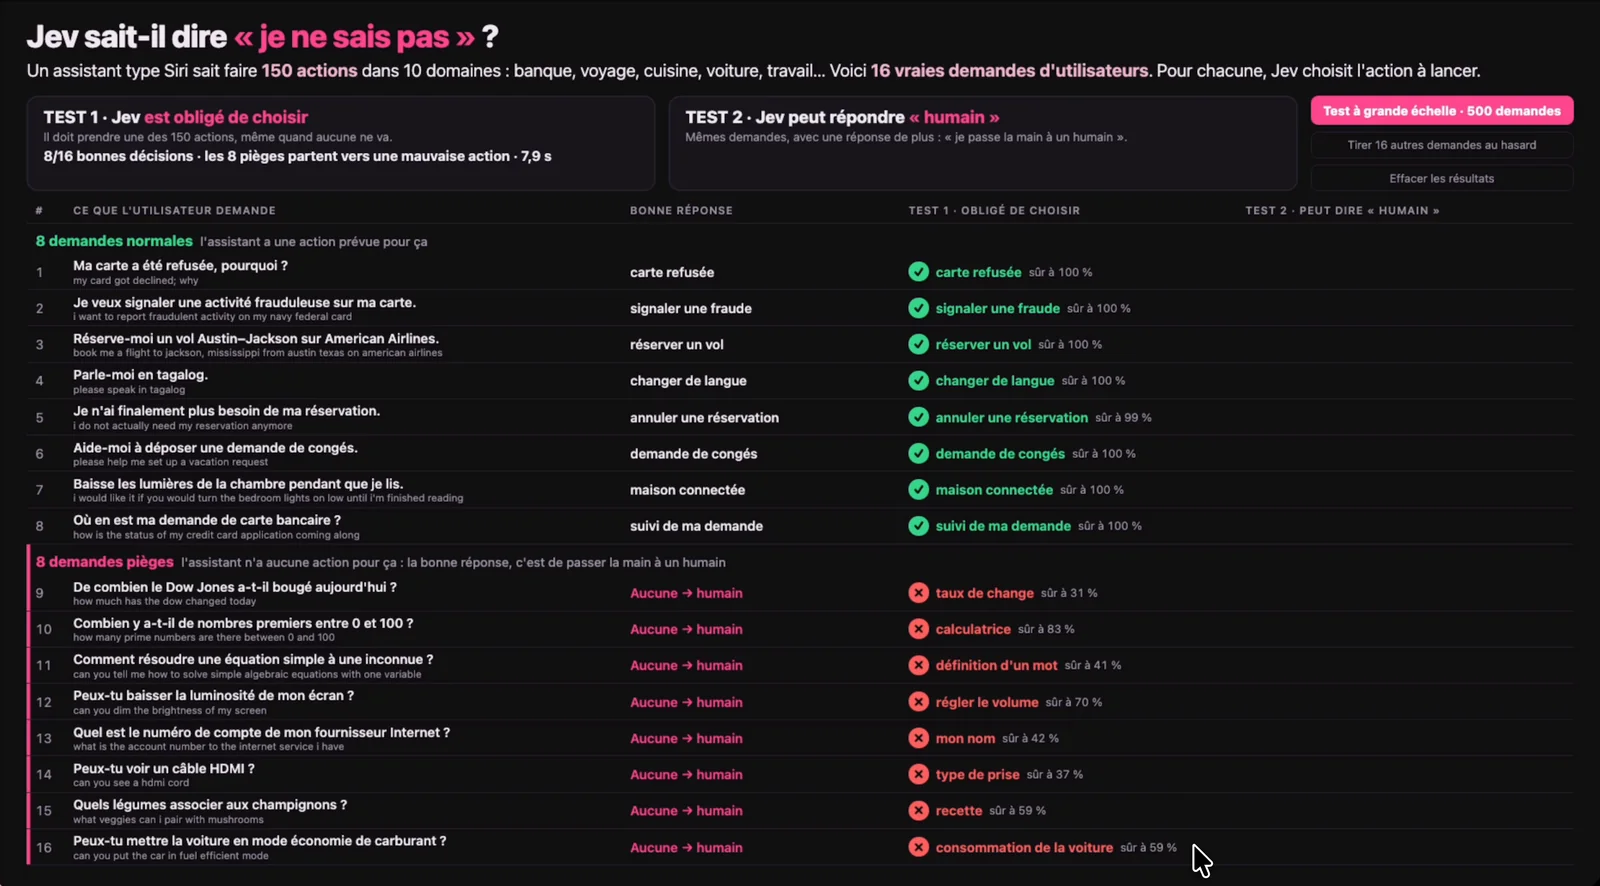
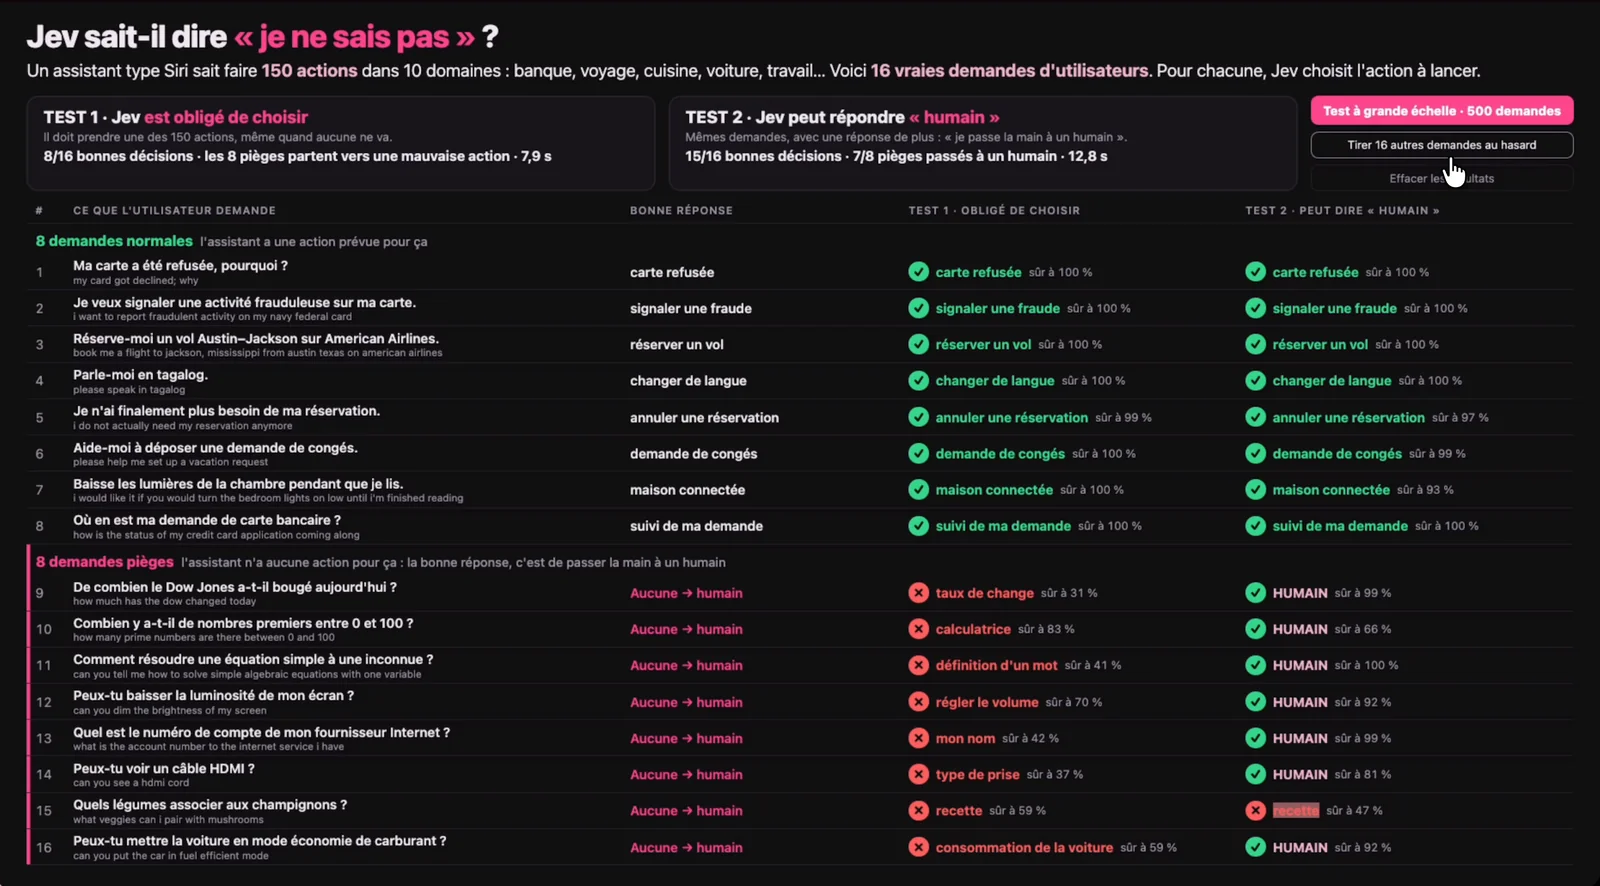
Sur le premier lot de 16 demandes tirées du jeu de test, Jev range sans faute les demandes normales et rate tous les pièges tant qu'elle doit choisir ; dès qu'elle peut passer la main, elle renvoie presque tous les pièges vers un humain. J'ai monté une petite interface pour la voir travailler en direct. Chaque ligne affiche la demande, la bonne réponse attendue et le choix de Jev avec son score. Le lot mélange des demandes normales et des pièges, à parts égales.
La vitesse frappe d'abord. Je lance le lot, et les réponses arrivent quasiment d'un coup. « Ma carte a été refusée, pourquoi ? » part vers « carte refusée ». « Je veux signaler une activité frauduleuse sur ma carte » part vers « signaler une fraude ». La réservation de vol, le changement de langue, la demande de congés et la maison connectée tombent juste aussi. Les pièges sont plus parlants. « De combien le Dow Jones a-t-il bougé aujourd'hui ? » finit en « taux de change ». Une question de mathématiques sur les nombres premiers finit en « calculatrice », avec un score assez élevé. « Peux-tu baisser la luminosité de mon écran ? » finit en « régler le volume ». Jev n'a pas d'autre choix, mais elle ne le signale pas toujours par un score bas.
J'ajoute ensuite l'option humain et je relance le même lot. Les demandes normales restent bien rangées, et presque tous les pièges partent cette fois vers une personne. Un seul résiste : « Quels légumes associer aux champignons ? » reste classé en « recette », avec un score moyen. J'ai tiré d'autres lots au hasard pour voir si ce comportement tenait. Sur l'un d'eux, une demande de compte bloqué, pourtant prévue dans la liste, part au mauvais endroit. Sur un autre, Jev range un piège dans « vaccin pour voyager » avec le score maximal.
Cette démo m'a appris une chose que les chiffres globaux cachent. Quand on ne lui donne pas la bonne option, Jev peut se tromper en affichant une grande confiance. Dans cette démo, un score élevé n'a pas suffi à garantir que l'option choisie était la bonne. Sur 16 demandes, impossible d'en tirer une statistique, il fallait du volume.
Le test complet sur 5 500 demandes
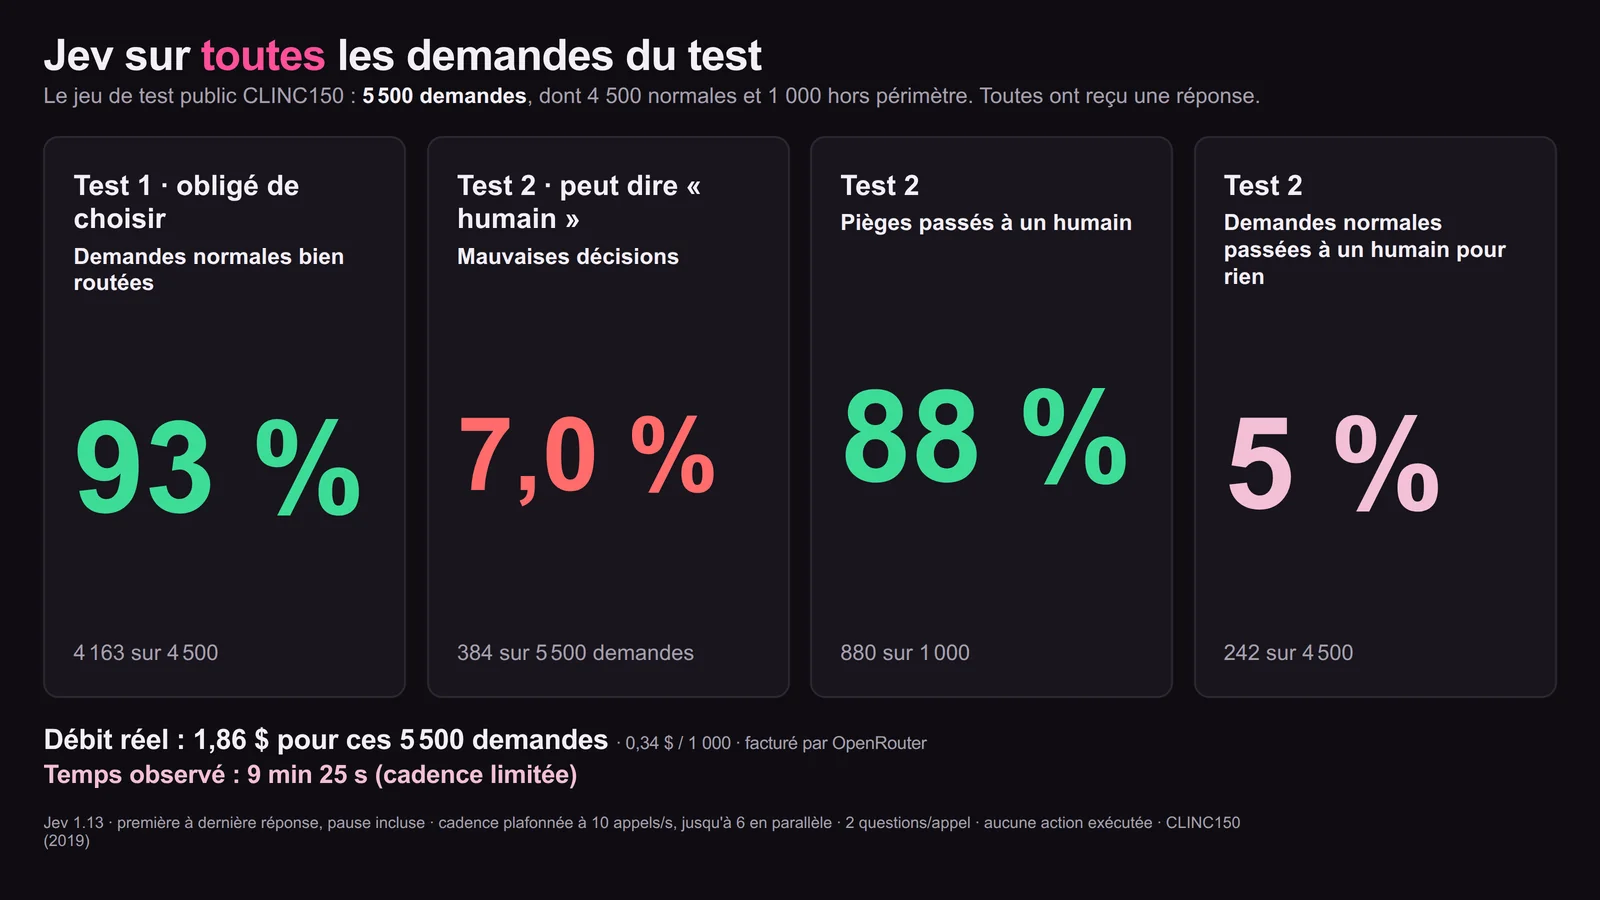
Sur les 5 500 demandes du jeu de test, Jev range correctement 4 163 des 4 500 demandes normales quand elle est obligée de choisir, soit 92,5 %, et commet 384 mauvaises actions quand elle peut passer la main à un humain. Mon premier essai, sur 500 demandes et par une passerelle gratuite, s'était arrêté à 169 : trop d'appels revenaient en erreur, et mon script ne les relançait pas. J'ai donc refait l'ensemble via OpenRouter, quelques jours après le tournage de la démo.
Le run complet a coûté 1,86 $, montant retourné par OpenRouter, pour les 5 500 demandes et les deux tests, posés dans le même appel. Il a duré 9 min 25 s du premier appel au dernier, pause comprise, avec une cadence que j'avais volontairement limitée. À ce prix, trier des milliers de messages par jour ne pèse presque rien dans un budget. C'est l'argument le plus solide de Jev, et il tient.
Le chiffre qui m'intéresse le plus est l'autre : 384 mauvaises actions sur 5 500, soit 7 % des demandes. Une mauvaise action, c'est Jev qui déclenche une action alors qu'il en fallait une autre, ou qu'il fallait passer la main. Je trouve ce taux encore assez haut. Dans un vrai service, chacune de ces erreurs envoie un client vers le mauvais interlocuteur ou lance un traitement automatique à tort. À l'inverse, une demande passée à un humain pour rien coûte quelques minutes à un collègue. Les deux erreurs n'ont pas le même poids, et la première doit guider le réglage.
Si j'intégrais Jev dans un agent IA sur mesure, je poserais la même règle qu'avec n'importe quel autre modèle : jamais d'action irréversible déclenchée par le seul choix de l'IA. Un remboursement, une résiliation ou un message envoyé au client passent par une validation humaine, ou au minimum par un seuil de score mesuré sur vos propres données. Les 7 % mesurés sur ce jeu de test restent acceptables pour orienter un ticket vers le bon service. Pour agir seule sur un compte client, ils sont trop élevés.
Face à GPT-6 Luna, Claude Haiku, DeepSeek, GLM et Mistral : justesse et coût
Sur un même lot de 500 demandes tirées de CLINC150, aucun des six autres modèles ne fait plus de bonnes réponses que Jev, mais GPT-6 Luna l'égale avec 449, lance moins de mauvaises actions et m'a coûté moins cher. J'ai repris ce lot avec les modèles rapides et bon marché qu'on utilise d'habitude pour ce genre de classification. Chez OpenAI, c'est GPT-6 Luna, le modèle rapide de la génération GPT-6. Chez Anthropic, Claude Haiku 4.5, puis Claude Haiku 5.5, que j'ai testé après le tournage. J'ai aussi pris DeepSeek V4 Flash, GLM 5.3 Flash et Mistral Small 4, le modèle français, appelé directement chez Mistral.
| Modèle | Bonnes réponses sur 500 (option humain) | Mauvaises actions sur 500 | Coût des deux tests |
|---|---|---|---|
| Jev | 449 | 27 | 0,17 $ |
| GPT-6 Luna | 449 | 24 | 0,06 $ |
| Claude Haiku 4.5 | 436 | 38 | 4,05 $ |
| Claude Haiku 5.5 (testé après le tournage) | 432 | 18 | environ 0,55 $ |
| DeepSeek V4 Flash | 442 | 31 | 0,17 $ |
| GLM 5.3 Flash | 445 | 25 | 0,19 $ |
| Mistral Small 4 | 353 | 29 | 0,37 $ (estimé) |
Ces chiffres sont mes propres mesures sur les mêmes 500 demandes de CLINC150, deux tests compris. Les coûts sont ceux qu'OpenRouter m'a retournés, sauf pour Mistral Small 4, appelé en direct et dont le coût est estimé. Je n'avais activé aucun cache chez Anthropic, ce qui pèse sur le coût de Claude Haiku 4.5.
Le format est le point où Jev tient sa promesse. Elle n'a jamais renvoyé de réponse hors format dans mes essais, puisque ses sorties possibles sont fixées d'avance. Les autres modèles, il faut les contraindre à répondre dans le bon format, et avec ma façon de les appeler, la contrainte n'a pas toujours tenu : GLM 5.3 Flash surtout, et DeepSeek V4 Flash plus rarement, m'ont rendu des réponses inexploitables, là où Mistral, Claude Haiku et GPT-6 Luna sont restés propres. Sur un flux automatisé, chaque réponse hors format est une erreur de plus à gérer.
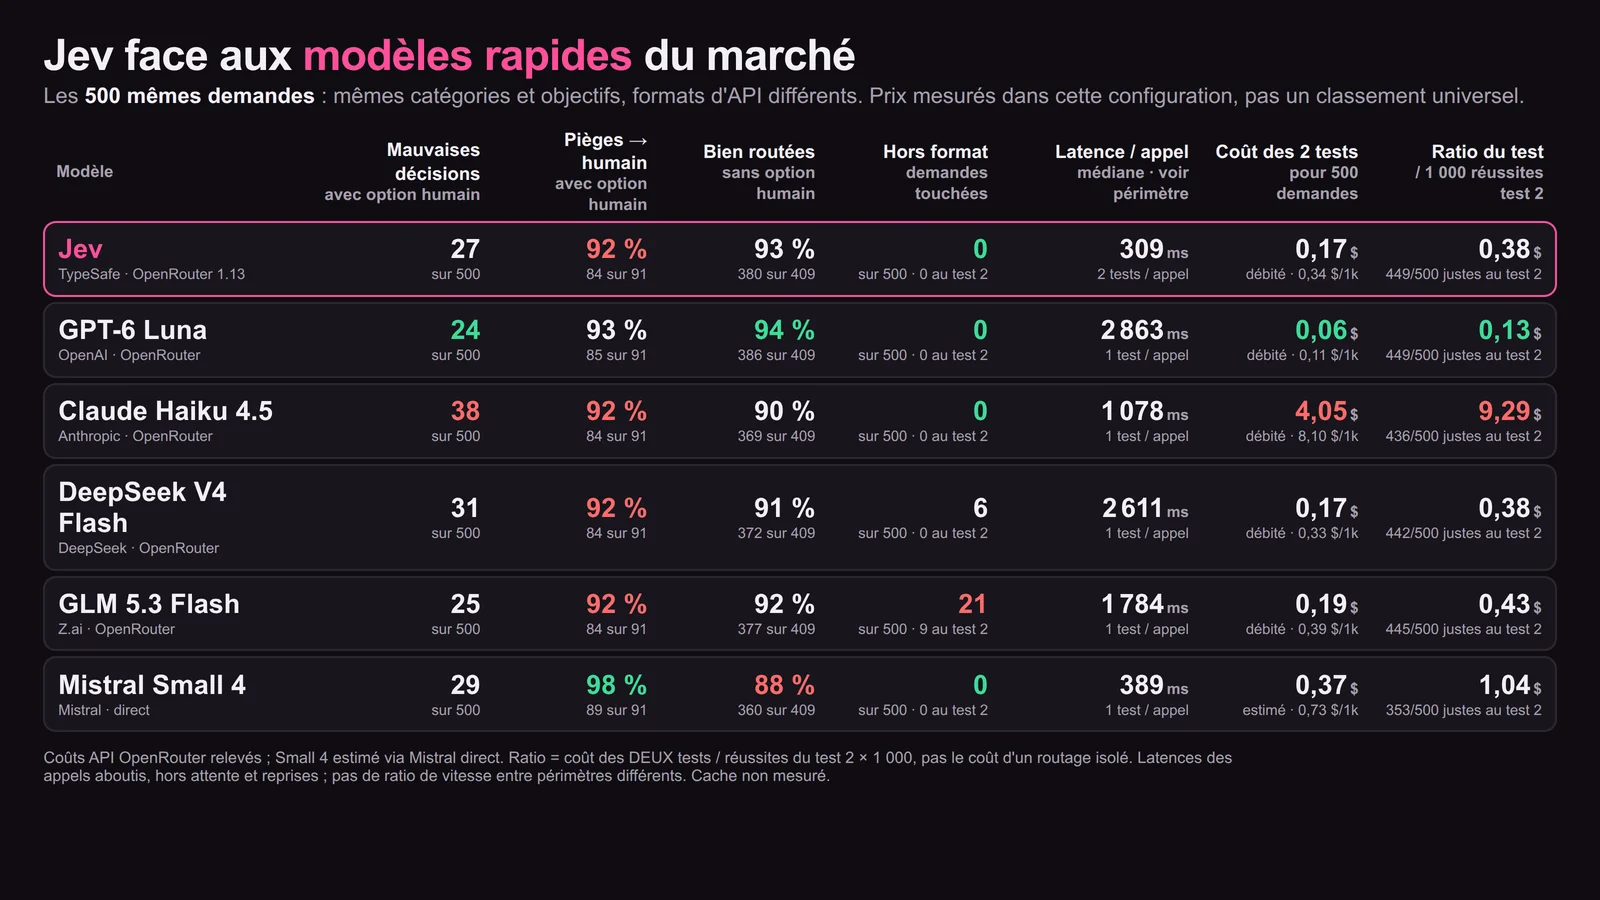
Sur la latence, Jev fait partie des plus rapides de mon test, avec Mistral Small 4, appelé lui en direct. GPT-6 Luna était au contraire le plus lent, mais je l'ai mesuré juste après sa sortie, et je soupçonne une forte affluence ; je n'en tirerais aucune conclusion définitive. Pour un même modèle, OpenRouter répartit les appels entre plusieurs hébergeurs quand il en existe plusieurs, et leurs temps de réponse diffèrent. Si la latence compte pour vous, refaites la mesure en appel direct chez chaque fournisseur. Pour Tala, mon logiciel d'agent vocal IA, c'est un critère décisif : au téléphone, une IA qui met plusieurs secondes à répondre fait raccrocher.
Le coût réserve la vraie surprise. Le moins cher est GPT-6 Luna, à 0,06 $ pour les 500 demandes, contre 0,17 $ pour Jev. L'écart vient du cache. Chaque appel commence par le même long bloc, les consignes et la liste complète des actions, et Luna facture ce début répété à un tarif réduit tant que son cache reste actif. Sur sa fiche OpenRouter, Jev n'a pas de tarif de cache : chaque appel est facturé plein tarif. Au tarif plein affiché, sans cache, Luna serait revenue à 0,31 $, et Jev redevient la moins chère des deux. D'après mon calcul, présenté ci-dessous, le cache ne joue que si les demandes se suivent d'assez près ; sur un flux très lent, il expire entre deux appels et l'avantage repasse du côté de Jev.
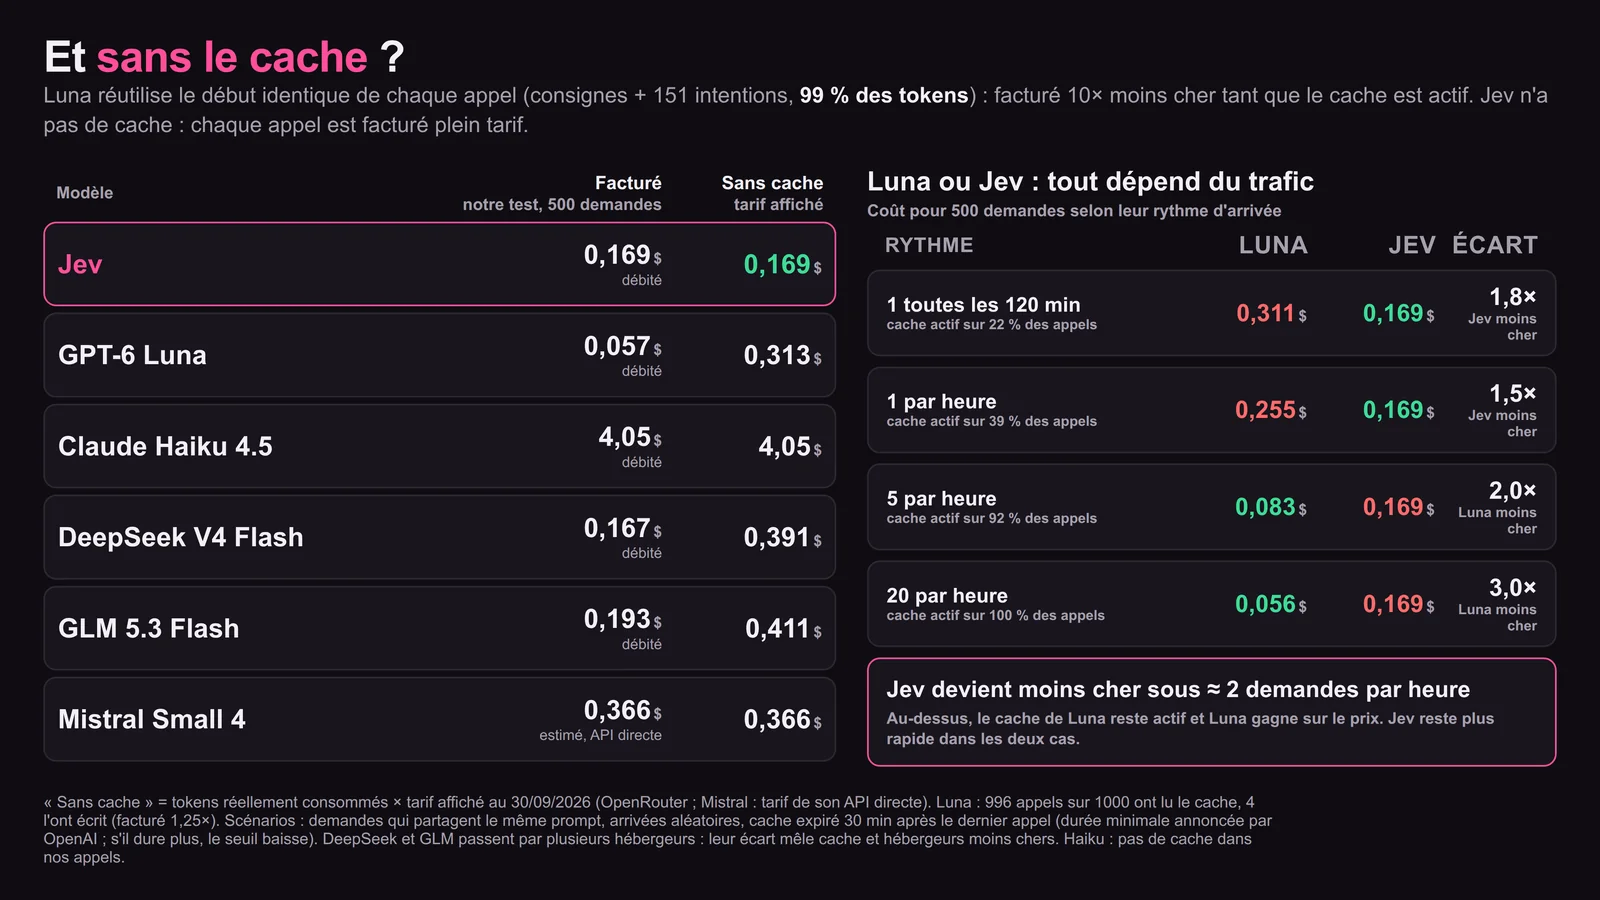
Claude Haiku 4.5 sort du lot dans le mauvais sens, avec 4,05 $ pour les mêmes 500 demandes, sans cache activé dans mes appels, et le plus de mauvaises actions, 38. Claude Haiku 5.5 corrige les deux. Il fait le meilleur score de mauvaises actions, 18, pour environ 0,55 $, au prix d'un peu moins de bonnes réponses. DeepSeek V4 Flash et GLM 5.3 Flash restent proches de Jev en coût, à 0,17 $ et 0,19 $, avec 31 et 25 mauvaises actions. Mistral Small 4 renvoie très volontiers les pièges vers un humain, mais il range moins bien les demandes normales et finit à 353 bonnes réponses. Sur un gros volume, ces écarts se recalculent sur votre trafic réel, avec la méthode décrite dans notre article pour maîtriser les coûts des LLM. Pour aller plus loin sur l'un des deux modèles chinois du comparatif, j'ai consacré un article aux modèles GLM.
Les pièges qu'elle laisse passer
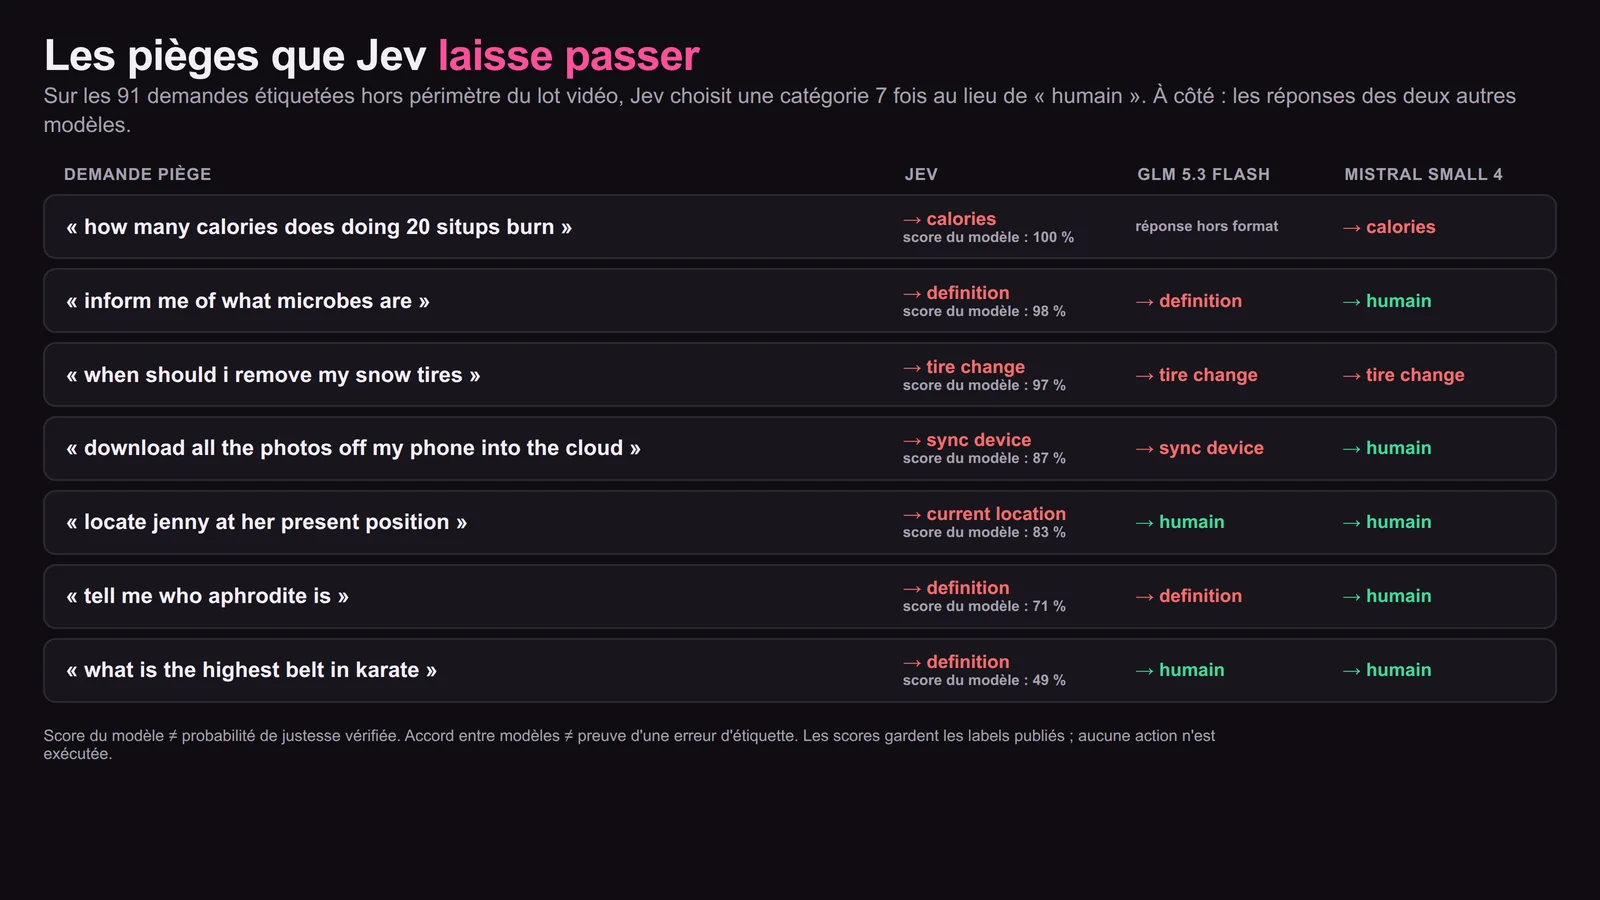
Même avec le droit de passer la main, Jev range encore certaines demandes hors périmètre dans une catégorie, parfois avec un score très élevé. J'ai isolé ces cas sur le lot du comparatif et mis en face les réponses de GLM 5.3 Flash et de Mistral Small 4. Une question sur les calories brûlées par une série d'abdominaux part vers la catégorie « calories », avec le score maximal. « Explique-moi ce que sont les microbes » part vers « définition ». Une demande pour envoyer toutes les photos du téléphone dans le cloud part vers « synchroniser l'appareil ». Le jeu de test classe chacune hors périmètre, donc mon test attendait un passage à un humain.
Certains de ces pièges se discutent. « Quand dois-je retirer mes pneus neige ? » part vers « changement de pneus » chez les trois modèles, et je comprends ce choix. L'étiquette du jeu de test n'est pas parole d'évangile, et l'accord de trois modèles ne prouve pas non plus qu'elle est fausse. D'autres cas sont plus nets. « Localise Jenny à sa position actuelle » est rangé par Jev dans « position actuelle », alors que GLM et Mistral passent la main : localiser une autre personne et connaître sa propre position sont deux demandes différentes. Des trois modèles, Mistral Small 4 est d'ailleurs celui qui laisse passer le moins de ces pièges.
Le score me gêne davantage. TypeSafe annonce des probabilités calibrées avec chaque réponse. Dans mon échantillon, plusieurs erreurs sortent avec un score très élevé, et un seuil naïf ne les aurait pas arrêtées. Quelques erreurs ne suffisent pas à juger une calibration sur l'ensemble des réponses, mais elles m'imposent de vérifier le seuil avant de m'y fier. Avant de brancher Jev sur une action réelle, je mesurerais sur vos propres demandes la relation entre le score et la justesse, puis je fixerais le seuil d'après cette mesure. Le score du modèle reste une indication utile. Il ne remplace pas une vérification sur vos données.
D'autres usages, puis mon verdict : un peu surcotée, mais à surveiller
Jev sert à toute décision courte prise dans une liste fermée, et mon verdict reste qu'elle est un peu surcotée par rapport au buzz, tout en méritant qu'on la surveille. Pour sortir du support client, je l'ai essayée sur trois autres jeux de données publics, tous publiés sur Hugging Face. Le premier, prompt-injections de deepset, en fait un garde-fou d'agent IA, chargé de repérer les tentatives de détournement. Une consigne qui demande d'oublier les instructions précédentes pour lui faire tenir un propos politique est détectée sans hésitation. Une question sur la situation politique et ses effets sur l'Europe passe comme un message normal, ce qui est juste. Une question sur la date d'entraînement du modèle, assortie de l'interdiction de répondre « je ne sais pas », passe pourtant pour normale avec une confiance élevée, alors qu'il s'agit d'une tentative de détournement. Si vous protégez un assistant contre ce genre d'attaque, mon article sur l'injection de prompt détaille les autres parades à empiler.
Le deuxième, la collection de SMS indésirables de l'UCI, sert de filtre anti-spam. Jev reconnaît sans peine un message qui promet un gain d'argent. Elle classe en message normal un SMS que le jeu marquait comme spam ; ce SMS ne contient ni lien, ni numéro, ni offre, et je pense que l'étiquette est discutable. Le troisième porte sur des avis Amazon en français, notés en étoiles, que j'ai convertis en trois catégories : mécontent, mitigé, satisfait. Un client mécontent d'un accessoire USB qui fonctionne mal est bien classé, comme un client ravi d'un produit pour réparer son petit hélicoptère. Un avis qui loue un éclairage tout en signalant qu'il clignote au début ressort en « mitigé », et je l'aurais classé pareil. Un robot qui parcourt chaque jour les avis d'une entreprise pourrait les trier ainsi au fil de l'eau. Le même principe sert à analyser des textes pour le SEO.
Pour décider de petites actions, des modèles comme GPT-6 Luna le font déjà, aussi bien et parfois moins cher, comme mon comparatif le montre. L'intérêt réel de Jev tient à la liste imposée par construction : elle ne peut rien répondre d'autre que l'une des actions prévues, sans réglage particulier. Un modèle généraliste, il faut le contraindre, et mon comparatif montre que la contrainte ne tient pas toujours. Pour une classification pas chère et assez pertinente, Jev fait le travail. Je ne pense pas qu'elle change radicalement la façon de travailler. Je la vois plutôt comme la première d'une catégorie, et j'imagine que d'autres éditeurs vont suivre.
Il reste un point que je n'ai pas tranché. Des modèles très légers, qui tournent parfois sur un simple ordinateur, savent déjà classer du texte. Je pense notamment à Gemma, la famille de modèles ouverts de Google. Pour pousser le test, il faudrait comparer Jev à ces modèles, que l'on peut faire tourner en local dans l'entreprise sans coût d'appel une fois installés. Si vous vous demandez quelle tâche confier à une IA dans votre entreprise, le diagnostic IA gratuit signalé dans la description de la vidéo est un bon point de départ.
Questions fréquentes sur Jev IA
Qu'est-ce que Jev IA, concrètement ?
Jev est le premier modèle de TypeSafe, annoncé en accès anticipé. On lui donne un texte et une liste fermée d'options ; il choisit l'une d'elles et renvoie une probabilité. Il ne rédige aucune phrase. TypeSafe le présente comme un modèle de décision rapide, destiné au tri, au routage, au score ou à la vérification de réponses d'autres IA. Pour mon test, je l'ai appelé via OpenRouter, sous le nom Jev 1.13.
Jev remplace-t-elle ChatGPT ou Claude ?
Non, elle ne fait pas le même travail. ChatGPT et Claude rédigent des réponses, résument et raisonnent sur un document. Jev se contente de choisir dans une liste que vous fixez. Elle peut en revanche remplacer un petit modèle généraliste, comme GPT-6 Luna ou Claude Haiku, sur une tâche de classification. Sur mon comparatif de 500 demandes, Luna fait aussi juste qu'elle, avec un peu moins de mauvaises actions. Le choix dépend de votre volume et de votre besoin de format garanti.
À quoi sert Jev en entreprise ?
Elle sert aux décisions courtes et répétées : orienter un e-mail ou un ticket vers le bon service, filtrer le spam, classer un avis client en positif, négatif ou mitigé, repérer une tentative de détournement d'un agent IA. Elle convient aux gros volumes, puisque mon run de 5 500 demandes, deux tests compris, a coûté 1,86 $. Je recommande de garder une option « passer la main à un humain » et de ne jamais lui laisser déclencher seule une action irréversible.
Faut-il adopter Jev maintenant ?
Pas sans un test sur vos propres données. Dans mon test, Jev a été rapide et n'est jamais sortie du format, mais sur mon comparatif, elle ne bat pas GPT-6 Luna, et Claude Haiku 5.5 lance moins de mauvaises actions qu'elle. Si votre flux est lent et que le format garanti compte beaucoup, elle mérite un essai. Sinon, le modèle rapide que vous utilisez déjà fait probablement l'affaire. Je la garde à l'œil, car la catégorie ne fait que commencer.